大模型训练
目录
简介
大模型:id 化导致模型变大,模型变大需要更多的数据才能收敛。
第一视角:深度学习框架这几年 作者深度参与了tf 等几个框架,对很多事情有独到的了解
什么是大模型
TensorFlow在推荐系统中的分布式训练优化实践随着美团业务的发展,推荐系统模型的规模和复杂度也在快速增长,具体表现如下:
- 训练数据:训练样本从到百亿增长到千亿,增长了近10倍。
- 稀疏参数:个数从几百到几千,也增长了近10倍;总参数量(也就是tf.Variable)从几亿增长到百亿,增长了10~20倍。
- 模型复杂度:越来越复杂,模型单步计算时间增长10倍以上。 对于大流量业务,一次训练实验,从几个小时增长到了几天,而此场景一次实验保持在1天之内是基本的需求。
深度学习分布式训练的现状及未来大模型主要分为两类:
- 搜索、推荐、广告类任务,它的特点是海量样本及大规模稀疏参数(sparse embeddings),适合使用 CPU/GPU 参数服务器模式(PS);参数服务器模式从第一代 Alex Smola 在 2010 年提出的 LDA(文本挖掘领域的隐狄利克雷分配模型),到第二代 Jeff Dean 提出的 DistBelief,接着到第三代李沐提出的相对成熟的现代 Parameter Server 架构,再到后来的百花齐放:Uber 的 Horvod,阿里的 XDL、PAI,Meta 的 DLRM,字节的 BytePs、美团基于 Tensorlow 做的各种适配等等。参数服务器的功能日趋完善,性能也越来越强,有纯 CPU、纯 GPU,也有异构模式。
- CV、NLP 任务,它的特点是常规样本数据及大规模稠密参数,它适合用纯 GPU 集合通信模式(Collective)。基于纯 GPU 的集合通信模式的分布式训练框架,伴随着 Nvidia 的技术迭代,特别是 GPU 通信技术(GPU Direct RDMA)的进步,性能也变得愈来愈强。
广告推荐中大规模分布式模型 为啥一两百类的特征,我们却总是听说大规模特征?举个例子,用户 userid 这一维特征,比如系统中用户有1亿个,那么每个 id 实际上也可以当做一个独立的特征对待。这样一算,特征规模就上去了。这里就要重新理解 embedding 的概念了。对于模型而言,id 查了embedding表后得到向量,输入进来进行计算,是对数据进行抽特征。如果类比到图像分类,抽取 rgb 特征来分类 (一个值变成 3个255)
参数量卷到一百万亿!华人团队开源史上最大的推荐训练系统Persia 一般来说,推荐系统模型首先需要将不同的ID特征(如用户ID和session ID)映射到一个固定长度的低维向量,而系统中的用户ID、交叉特征数量都特别多,就需要更大规模的模型来捕获特征和映射。但更大规模的embedding layer也需要更大的内存来载入,不得不说大模型太费钱了!
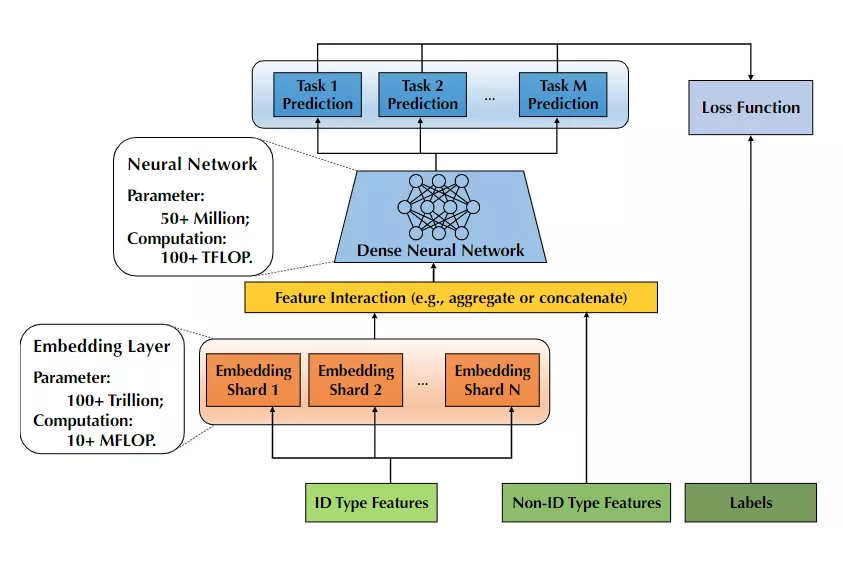
有了embedding后,剩下的工作就简单了,设计后续layer来适配不同的任务。通常只占据整个模型的0.1%,无需大内存,主要是一些计算密集型的工作。
在实现上
- 推理服务在运行时 也会访问ps (distributed inference),根据 ID feature 查询对应的 embedding 向量。当然,有的框架直接将 ps 组件的功能内嵌到各个worker 上了。
- 针对 大模型 包含 embedding layer的场景,input 层和 embedding 层之间不是全连接的,而是一个 embedding_lookup 的Op
- 常规的dense 模型,input是一个一维向量。 针对多个id feature,为了 确保与模型的input 层对齐,input 实际变成了一个
map<string,tensor>,key 为id feature 名字,value 为id feature 值对应的 tensor。
大了难在哪
参数量卷到一百万亿!华人团队开源史上最大的推荐训练系统Persia模型训练时消耗的显存,往往是参数量的几倍还多。
CV和NLP场景
浅谈工业界分布式训练(一) 除了上述的数据量级大,不同场景下分布式训练的痛点 对CV和NLP场景
- CV和NLP场景模型复杂,单机性能要求高,比如卷积的计算时间在CPU上和 GPU上相差十倍到几十倍。 ==> 业界主要使用高性能的GPU进行计算,并采用All-reduce的通信拓扑进行参数的同步更新。
- 模型大(DenseNet部分),比如NLP领域,GPT-3这样的模型高达1750亿参数,显存占用高达2.8 TB,单机内存无法容纳。而Bert-Large虽然只有3.4亿参数规模,但由于各种内存占用,在16G V100上,训练也仅能使用batch Size=8。 ==> 当面对GPT-3这种DenseNet部分大的模型,Allreduce 单卡内存无法容纳,我们需要采用模型并行(model parallelism)的方式将计算图划分到不同的设备上构建有向无环图(DAG)进行分布式训练,其中Gpipe, Megatron, Oneflow和Whale都提出模型并行的相关解决方案。相比于数据并行每个worker只有一部分数据,模型并行下每个node使用所有数据.
- Intra-layer parallelism(Tensor Parallelism) 。主要是将一层Layer中的矩阵计算分别拆分到不同的机器上进行运算,比如简单的Y_1=W_1 X_1这一次矩阵乘法中,我们将模型参数W_1或者输入数据X_1,按某个维度分别拆分到不同设备上计算,比如1D Megatron。
- Inter-layer parallelism(Pipeline Parallelism)。而Inter-Layer Parallism会将模型的layers拆分到不同的机器上,则一次forward就需要跨过不同的机器串行地进行运算,而流行并行通过将batch size切分为更小的mirco batch,减少数据依赖,从而将整个计算过程异步起来,最大化资源利用率。举例来说,在一个简单的三层MLP中(的Y_i = W_i X_i, i=1,2,3)会存在三次矩阵乘法 W_i X_i,流水线并行会把W_i X_i分别分配到三台机器上进行运算。
推广搜场景
- 模型小,词表大。模型中的DenseNet部分,不像BERT是模型巨大词表小,往往一台机器的内存就可以容纳,但是其特征量级可能高达成百上千亿,造成Sparsenet部分或者Embedding lookup table高达TB级别,使得单机无法容纳。
- 一个batch的embedding lookup量级大,造成查询耗时大。由于特征数量多,一个batch可能包含几十万个ID类特征,tf原生的embedding lookup查询耗时大,造成训练和inference性能低。尤其在线上inference的时候,无法在给定RT内完成服务响应。
- 数据具有大规模稀疏的特点。不同于CV和NLP场景,数据是稠密的图像和文本,搜广推的数据非常稀疏的,第一这来源于很多数据无法对所有用户和场景有效采集到,第二是因为建模使用的特征量级大造成的高维稀疏性。这会影响了数据的存储格式和计算效率。
TensorFlow在美团外卖推荐场景的GPU训练优化实践 推荐系统深度学习模型特点
- 读取样本量大:训练样本在几十TB~几百TB,而CV等场景通常在几百GB以内。
- 模型参数量大:同时有大规模稀疏参数和稠密参数,需要几百GB甚至上TB存储,而CV等场景模型主要是稠密参数,通常在几十GB以内。
- 模型计算复杂度相对低一些:推荐系统模型在GPU上单步执行只需要10~100ms,而CV模型在GPU上单步执行是100~500ms,NLP模型在GPU上单步执行是500ms~1s。 GPU服务器特点
- GPU卡算力很强,但显存仍有限:如果要充分发挥GPU算力,需要把GPU计算用到的各种数据提前放置到显存中。而从2016年~2020年,NVIDIA Tesla GPU卡计算能力提升了10倍以上,但显存大小只提升了3倍左右。
- 其它维度资源并不是很充足:相比GPU算力的提升速度,单机的CPU、网络带宽的增长速度较慢,如果遇到这两类资源负载较重的模型,将无法充分发挥GPU的能力,GPU服务器相比CPU服务器的性价比不会太高。
模型保存
- 在模型比较小的时候,比如100G以下,模型还有可能单机存储。这个时候的方案是tensorflow分布式训练+savedmodel,分布式训练可以用多个ps(tensorflow自带的),资源管理可以用yarn。用分布式是由于样本数大,同时多ps也能异步加速训练。saved_model一般由chief worker保存,但存下来以后,会抹掉ps的痕迹,保存的模型跟单机训练的一模一样。
- 当模型比较大的时候,这个时候要求的样本数也更大,训练完dump出来的模型会很大,一个单机放不下,尤其是embedding table。这个时候怎么办?一个自然的思路就是,把训练时候的ps拷贝同步一份给serving ps,线上由该ps做serving。注意后面谈到的serving ps,都是自己开发或者根据某个开源软件修改而成(比如ps-lite)。如果是天级模型,可以用tensorflow原生的worker和train ps,但依然用saved model方式把模型存放到hdfs,然后从hdfs读入另外一个serving ps。如果是实时训练,则serving ps还得跟训练ps进行实时的网络连接,在内存就解决掉weight同步的处理,这个时候就不能用tensorflow原生的ps了,因为原生的ps没有实现同步接口。ps变了,worker也得跟着变,worker大多数都是基于tensorflow的c++底层接口开发,底层用到tf的session接口。
解决思路
针对上述的问题,各个大厂的训练框架进行很多相关优化,目前总结下来,核心的两点,一个在于分布式通信拓扑的设计,还有一个在于Embedding Lookup的性能优化。
只要单卡放的下,走数据并行,ps 或allreduce 都行,allreduce 通信成本小一些。若规模变大
- 稀疏模型,稀疏参数特殊处理
- 使用ps,加上一些稀疏tensor 的优化,且将 embedding 存储和更新 负担转嫁到 ps
- 稠密参数allreduce,想办法解决 稀疏tensor 的存储、通信成本。 比如 HybridBackend架构中参数放在 worker 上:稠密参数 replication 存放,每个 worker 都有副本,梯度更新时进行 allreduce;稀疏参数 partition 存放,每个 worker 只有部分分片,梯度更新时进行 alltoall。allreduce 和 alltoall 都会使用 nccl 进行同步通信,效率较高。hb 进行 alltoall 时,通信的是稀疏梯度,而不是完整的参数,通信量上和 ps 是一致的,但是通信效率会更高。
- 稠密模型,单卡无论如何也放不下了,就只能采取模型并行 及附属的一些优化方案
- 算子拆分 单个矩阵乘法可以分到两个device上计算
Y = WX = [W1,W2]X = [W1X,W2X]。我们在工程上要做的就是:将切分到两个device上,将复制到两个device上,然后两个device分别做矩阵乘法即可。有的时候,切分会带来额外的通信,比如矩阵乘法切到了reduction维度上,为了保持语义正确,就必须再紧跟一个AllReduce通信。 这里复杂之处在于,你不能无脑地将所有算子全部做拆分,因为拆分可能会引入一些额外通信,降低总体吞吐。所以你得做些分析,决定哪些算子被拆分,现在大部分框架都不支持这种全自动化策略,要么是半自动或纯手工,要么是针对某种模型把它的拆分方案写死。所以只能造轮子解决这个事 - 流水并行 不切算子,而是将不同的Layer切分到不同的Device上,就可以形成Pipeline方案,GPipe就是这样一种方案,提出了将一个batch拆分成若干个micro-batch,依次推入到Pipeline系统中,即可消除Bubble time。和算子拆分类似,全自动化方案工作量不小,比如Pipeline怎么切,才能让通信量小,计算还能均匀,这需要一定的算法和工程量
我们的模型可能会很大,或者数据量会很大。仅仅用一块GPU卡可能连模型都放不下,或者batch size只能设置的很小,但是我们知道有些情况下大的batch size往往会提供更好的效果。
- 假设我们只有一个GPU,我们的模型一次只能输入batch size为8的数据,那么我们怎么样实现batch size为32的更新呢?那就需要时间换空间了,即我们训练32/8=4步才去更新模型,也就是所谓的梯度累积。
- Gradient-Checkpointing, 那么如果你的GPU连batch size为1都跑不了怎么办?我们在训练深度学习模型的时候,需要先做前向传播,然后将中间得到的激活值存储在内存中,然后反向传播的时候再根据loss和激活值计算梯度。也就是说内存消耗其实跟模型的层数线性相关。那么怎么减少这个内存消耗呢?最简单的想法就是我不存这些中间信息,计算梯度的时候,到了某一层我重新计算它的激活值,这个方法虽然可以让内存消耗是个常量,但是运行时间会是
O(n^2),这是没法接受的。那么就有一个折中的办法,我不存全部的中间数据,只存部分,那么我们在计算梯度的时候不需要从头计算了,只需要从最近的checkpoint点计算就好。 - 我们训练模型一般都是用单精度(FP32)的参数,但是其实我们还使用半精度(FP16)。半精度可以降低内存消耗,从而训练更大的模型或者使用更大的batch size;同时运算时间受内存和算术带宽的限制,在有些gpu(Tensor cores)上可以为半精度提供更大的算术带宽,从而提高训练效率,减少inference用时。