mysql 事务的隔离级别
目录
前言
计算机科学中有一种思想:如果一个问题太难了解决不了,那就放宽假设,弱化需求。比如实现数据库事务的“隔离性”会导致性能很差,只能在实验室环境使用,无法用在现实世界,于是人们提出“弱隔离性”,罗列出“读提交”,“可重复读”之类的“弱隔离级别”,越弱的问题越好解决;比如想实现“对业务透明”的分布式事务比较难,要付出很多代价,于是人们就提出放弃“对业务透明”,于是就有了 TCC 和 Saga;……
可能你对隔离性还有点陌生,其实在编程的过程中,我们通常会利用锁进行并发控制,确保临界区的资源不会出现多个线程同时进行读写的情况,这其实就对应了事务的最高隔离级别:可串行化,它能保证多个并发事务的执行结果和一个一个串行执行是一样的。为什么应用程序中可以提供可串行化的隔离级别,而数据库却不能呢?根本原因就是应用程序对临界区大多是内存操作,而数据库要保证持久性(即 ACID 中的 Durability),需要把临界区的数据持久化到磁盘,可是磁盘操作比内存操作要慢好几个数量级,一次随机访问内存、 SSD 磁盘和 SATA 磁盘,对应的操作时间分别为几十纳秒、几十微秒和几十毫秒,这会导致临界区持有的时间变长,对临界区资源的竞争将会变得异常激烈,数据库的性能则会大大降低。所以,数据库的研究者就对事务定义了隔离级别这个概念,也就是在高性能与正确性之间提供了一个缓冲地带,相当于明确地告诉使用者,我们提供了正确性差一点但是性能好一点的模式,以及正确性好一点但是性能差一点的模式,使用者可以按照自己的业务场景来选择。
为什么要有事务隔离级别?
浅谈对数据库隔离级别的理解”隔离性”实质上就是指对数据操作的并发控制。
为什么需要并发控制?它解决了什么问题?在数据库中,如果对于同一数据项的所有事务操作都被串行化地执行,那么执行过程与结果是没有问题的。如果存在并发操作,即多个事务的生命周期(时间区间)之间存在交集,就可能产生操作上的冲突和依赖,进而引发异常现象。操作顺序类型可以分为 读-读、读-写、写-读、写-写 4种类型,其中后三种包含写的操作序列是有冲突的,它们可能会引发执行结果的异常(其实就是与串行执行结果不一样),或者叫异常现象(Anomaly),比如脏读等。PS:因为数据不是写入就算,而是commit 才算数,所以对另一个事务来说,“眼见不一定为实”,看见X=10,结果可能因为事务执行失败X后来不是10了。PS:一系列操作时不可能一瞬间执行完,所以我们在执行多个操作时,要控制他们的中间状态对外的可见性。
并发控制就是要解决这些异常,但是并发控制需要达到什么程度呢?因为并发控制程度高对应着并发执行效率低,数据库用户并非时刻都需要最强的并发控制方式,这是一致性与并发度的权衡,隔离级别就是这一权衡的控制参数。从数据库开发者的角度来看,需要解决并发操作时的异常现象是根本需求,而隔离级别是把这些无穷多的现象级需求进行了分类、抽象、归纳,将规避异常现象之需求转化为了满足有限种类隔离级别之需求。即数据库开发者只需要实现定义好的几种隔离级别,就可以为数据库系统提供规避某些(可能是无穷多)异常现象的功能。如果一个事务系统在运行时能够规避某些问题集,那么该系统的事务将具有某种相应的隔离级别,即隔离级别抽象出待规避的最小异常现象集合。至于DBMS的某种隔离级别的实现,是否还可能规避对应级别的最小问题集以外的异常序列,并不做限制。
数据库事务隔离发展历史事务隔离是事务并发产生的直接需求,最直观的、保证正确性的隔离方式,显然是让并发的事务依次执行,或是看起来像是依次执行。但在真实的场景中,有时并不需要如此高的正确性保证,因此希望牺牲一些正确性来提高整体性能。通过区别不同强度的隔离级别使得使用者可以在正确性和性能上自由权衡。随着数据库产品数量以及使用场景的膨胀,带来了各种隔离级别选择的混乱,数据库的众多设计者和使用者亟需一个对隔离级别划分的共识,这就是标准出现的意义。
如何标准化、形式化地描述并发读写的(异常)现象?1992年ANSI首先尝试指定统一的隔离级别标准,其定义了不同级别的异象(phenomenas), 并依据能避免多少异象来划分隔离标准。几年后,微软的研究员们在A Critique of ANSI SQL Isolation Levels一文中对ANSI的标准进行了批判,改造了异象的定义,本质是基于锁的定义,但太过严格的隔离性定义,阻止了Optimize或Multi-version的实现方式中的一些正常的情况。Adya在Weak Consistency: A Generalized Theory and Optimistic Implementations for Distributed Transactions中给出了基于序列化图得定义,思路为先定义冲突关系;并以冲突关系为有向边形成序列化图;再以图中的环类型定义不同的异象;最后通过阻止不同的异象来定义隔离级别。写写冲突ww;先写后读冲突wr;先读后写冲突rw。PS:总之挺麻烦一件事。
并发控制
浅析数据库并发控制实现事务隔离的机制,称之为并发控制。并行执行的事务可以满足某一隔离性级别的正确性要求。要满足正确性要求就一定需要对事务的操作做冲突检测,对有冲突的事务进行延后或者丢弃。并发控制机制 根据检测冲突的时机不同可以简单分成三类:
- 基于Lock:最悲观的实现,需要在操作开始前,甚至是事务开始前,对要访问的数据库对象加锁,对冲突操作Delay;
- 基于Timestamp:乐观的实现,每个事务在开始时获得全局递增的时间戳,期望按照开始时的时间戳依次执行,在操作真正写数据的时候检查冲突并选择Delay或者Abort;
- 基于Validation:更乐观的实现,仅在Commit前进行Validate,对冲突的事务Abort
三种策略的立足点其实是对冲突的乐观程度,越乐观,也就是认为冲突发生越少,就越倾向于推迟冲突的检测。直观的也可以看出,越晚的冲突检测越有可能获得高的并发。但当冲突真正出现时,由于前面的操作可能都需要一笔勾销,因此在冲突较多的场景下,太乐观反而得不偿失。
相同的乐观程度下,还存在多版本的实现。所谓多版本,就是在每次需要对数据库对象修改时,生成新的数据版本,每个对象的多个版本共存。读请求可以直接访问对应版本的数据,从而避免读写事务和只读事务的相互阻塞。当然多版本也会带来对不同版本的维护成本,如需要垃圾回收机制来释放不被任何事物可见的版本。
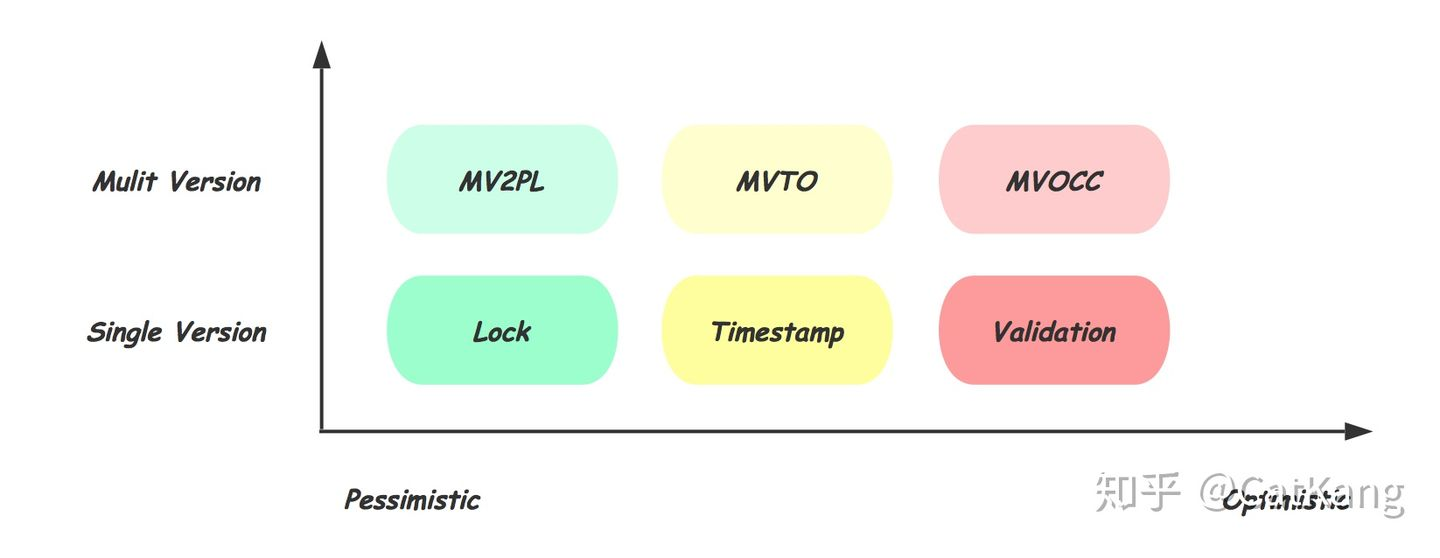
并发控制机制并不与具体的隔离级别绑定。无论是乐观悲观的选择,多版本的实现,读写锁,两阶段锁等各种并发控制的机制,归根接地都是在确定的隔离级别上尽可能的提高系统吞吐,可以说隔离级别选择决定上限,而并发控制实现决定下限。
基于 B+Tree 和 Lock 方式的并发控制
B+树数据库加锁历史如何选择Lock/Timestamp/Validation 归根结底是由用户的使用场景决定的,在不能对用户场景做太多假设的通用数据库中,毫无疑问,基于Lock的方式显得更为合适。除此之外,由于MVCC的广泛应用消除了读写之间的冲突,使得Lock带来的并发影响大大降低,也使得基于Lock的并发控制仍然是主流。
对数据库的数据加锁这件事情,本身是跟数据的组织方式是密不可分的,数据组织方式可能给加锁带来限制,同时利用组织方式的特性,可能也能改造和优化加锁过程。如何在B+Tree数据库上,基于Lock的方式,来实现高并发、高效的数据库并发控制?B+Tree加锁的发展历史(不是很专业,就不介绍那么细了)
- 2PL,由于B+Tree的从根向下的搜索模式,事务需要持有从根节点到叶子节点路径上所有的锁。而两阶段锁(2PL)又要求所有这些锁都持有到事务Commit。更糟糕的是,任何插入和删除操作都有可能导致树节点的分裂或合并(Structure Modification Operations, SMO),因此,对根结点需要加写锁WL,也就是说任何时刻只允许一个包含Insert或Delete操作的事务进行。
- Tree Protocol。略。2PL和Tree Protocol中面临的最大问题其实在于:节点的SMO时需要持有其父节点的写锁。之所以这样,是由于需要处理父节点中的对应key及指针,节点的分裂或合并,跟其父节点的修改是一个完整的过程,不允许任何其他事务看到这个过程的中间状态。
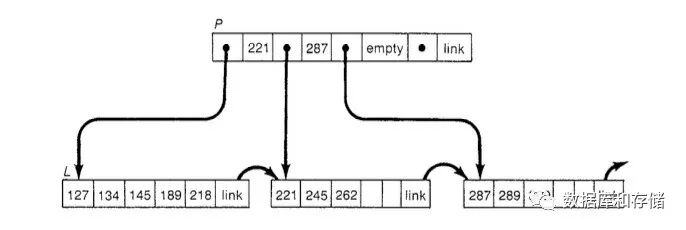
- Blink Tree。巧妙的提出对所有节点增加右向指针,指向其Sibling节点,这是个非常漂亮的解决方案,因为他其实是提供了一种新的节点访问路径,让上述这种SMO的中间状态,变成一种合法的状态,从而避免了SMO过程持有父节点的写锁。
- ARIES/KVL 峰回路转。上面讲到的传统的加锁策略,认为Btree的节点是加锁的最小单位,而所做的努力一直是在降低单个事务需要同时持有的锁的节点数,能不能更进一步提升Btree的并发能力呢?ARIES/KVL首先明确的区分了B+Tree的物理内容和逻辑内容,逻辑内容就是存储在B+Tree上的那些数据记录,而B+Tree自己本身的结构属于物理内容,物理内容其实事务是不关心的,那么节点分裂、合并这些操作其实只是改变了B+Tree的物理内容而不是逻辑内容。因此,ARIES/KVL就将这些从Lock的保护中抽离出来,也就是Lock在Record上加锁,对物理结构则通过Latch来保护其在多线程下的安全。这里最本质的区别是Latch不需要在整个事务生命周期持有,而是只在临界区代码的前后。可以看作是分层事务的一种实现。
- Latch保护物理结构。Latch才是我们在多线程编程中熟悉的,保护临界区访问的锁。通过Latch来保护B+Tree物理结构其实也属于多线程编程的范畴,上述传统的B+Tree加锁方式的优化,也可以直接无缝转化过来。只是将Lock换成的Latch,其作用对象也从事务之间变成线程之间。
- Lock保护逻辑结构。有了这种清晰的区分,事务的并发控制就变得清晰很多,不再需考虑树本身的结构变化。假设事务T1要查询、修改、删除或插入一个Record X,而Record X所在的Page为q,那么加Lock过程就变成这样:
 Search(X)and Hold Latch(q);
 SLock(X) or WLock(X);
 // Fetch, Insert or Delete
 Unlatch(q);
 ....
 T Commit and Unlock(X)
- Key Range Locking,前面这套结合Latch和Lock方案,已经可以很好的支持对单条Record的增删改查。但很多数据库访问并不是针对某一条记录的,而是基于条件的。比如查询满足某个条件的所有Record,这个时候就会出现《数据库事务隔离发展历史》中提到的幻读的问题,也就是在事务的生命周期中,由于新的满足条件的Record被其他事务插入或删除,导致该事务前后两次条件查询的结果不同。这其实是要求,条件查询的事务和插入/删除满足这个条件Record的事务之间,有相互通信或冲突发现的机制,最直接的想法是对所有可能的,还不存在的Key也加锁,在大多数情况下,由于Key范围的无限,这都是不可接受的。传统的解决幻读的方案是谓词锁(Predicate Lock),也就是直接对查询条件加锁,每次插入删除需要判断是否与现有的判断条件冲突,但通用数据库中,条件千变万化,判断条件冲突这件事情开销极大。也正是因此,谓词锁并没有成为主流。在B+Tree上,由于其Key有序的特点,通常会采用Key Range Locking,也就是对Key加锁,来保护其旁边的区间Range。其中最常见的一种实现是Next Key Locking。
- Instant Locking,上述加锁过程中,Insert需要对要插入位置的Next Key加Lock,如果已经是最大则需要对正无穷加Lock,并持有整个事务生命周期。在高频率顺序插入的场景,这个Next Key Lock就会成为明显的瓶颈。Instant Locking的方案很好地解决了这个问题。顾名思义,Instant Locking只在瞬间持有这把Next Key Locking,其加锁是为了判断有没有这个Range冲突的读操作,但获得锁后并不持有,而是直接放锁。乍一看,这样违背了2PL的限制,使得其他事务可能在这个过程获得这把锁。通过巧妙的利用Btree操作的特性,以及Latch及Lock的配合,可以相对完美的解决这个问题,如下是引入Instant Locking后的Insert加Next Key Lock的流程:
 Search(M,Y)and Hold Latch(q);

 XLock(Y);
 Unlock(Y)

 XLock(M);

 Insert M into q

 Unlatch(q);
 ....

 T Commit and Unlock(M)
可以看出,Y上Lock的获取和释放,和插入新的Record两件事情是在Page q的Latch保护下进行的,因此这个中间过程是不会有其他事务进来的,等Latch释放的时候,新的Record其实已经插入,这个X到Y的区间已经被划分成了,X到M以及M到Y,新的事务只需要对自己关心的Range加锁即可。分析这个过程,可以提前放锁的根本原因是:Insert的New Record在其他事务对这个Range加锁的时候已经可见。Delete就没有这么幸运了,因为Delete之后这个Key就不可见了,因此Delete的持有的Next Key Locking似乎不能采用Instant Locking,这个时候Ghost Record就派上用场了。
- Ghost Records,Ghost Record的思路,其实跟之前讲到拆分物理内容和逻辑内容是一脉相承的,Ghost Record给每个记录增加了一位Ghost Bit位,正常记录为0,当需要删除某个Record的时候,直接将其Ghost Bit修改为1即可,正常的查询会检查Ghost Bit,如果发现是1则跳过。但是Ghost Record是可以跟正常的Record一样作为Key Range Lock的加锁对象的。可以看出这相当于把删除操作变成了更新操作,因此删除事务不再需要持有Next Key Lock。除此之外,由于回滚的也变成了修改Ghost Bit,不存在新的空间申请需要,因此避免了事务回滚的失败。Ghost Record的策略也成为大多数B+Tree数据库的必选实现方式。当然,这些Ghost Record最终还是需要删除的,其删除操作通常会放到后台异步进行,由于Ghost Record对用户请求是不可见的,因此这个删除过程只是对物理结构的改变,也不需要加Lock。但Record的删除会导致其左右的两个Lock Range合并,因此这个过程除了需要Page的Latch之外,还需要获得Lock系统中Lock的Latch,在Lock的Latch保护下对Lock Range合并。
- 后续的研究多围绕权衡Lock粒度、新的Lock Mode及缩短Lock持有时间等方向继续前进。事务在操作数据库时,会先对要访问的元素加对应的Lock,为了更高的并发, Lock通常有不同的Mode,如常见的读锁SL,写锁WL,不同Mode的锁相互直接的兼容性可以用兼容性表来表示。
调度器
需要指出的是并发控制由数据库的调度器负责,事务本身并不感知。如下图所示,Scheduler将多个事务的读写请求,排列为合法的序列,使之依次执行:
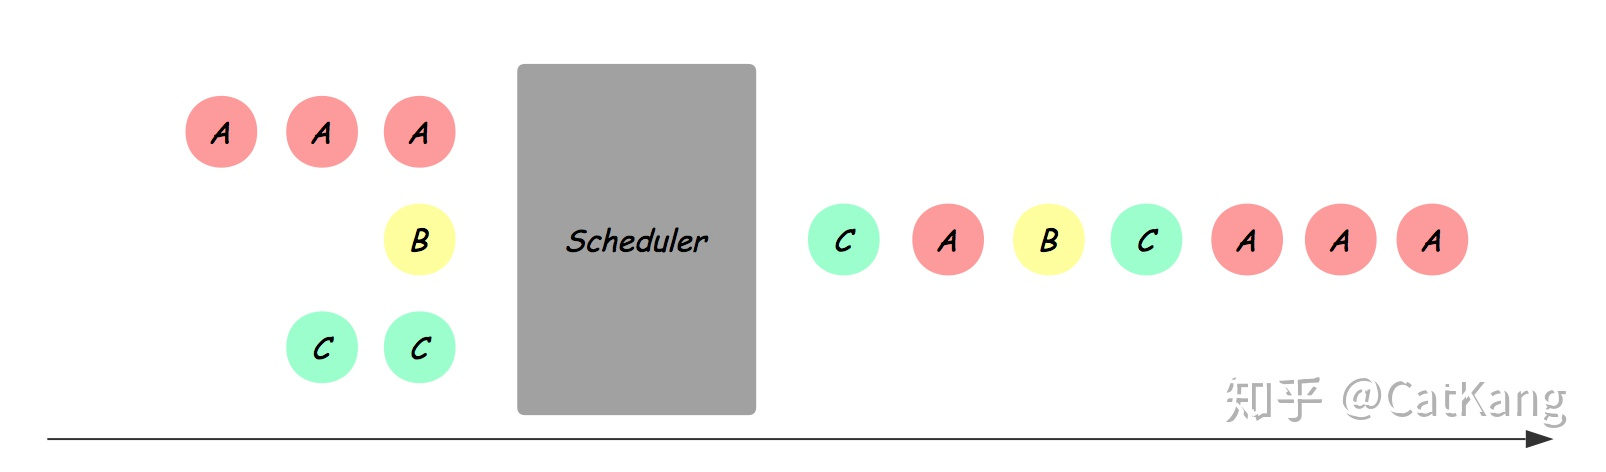
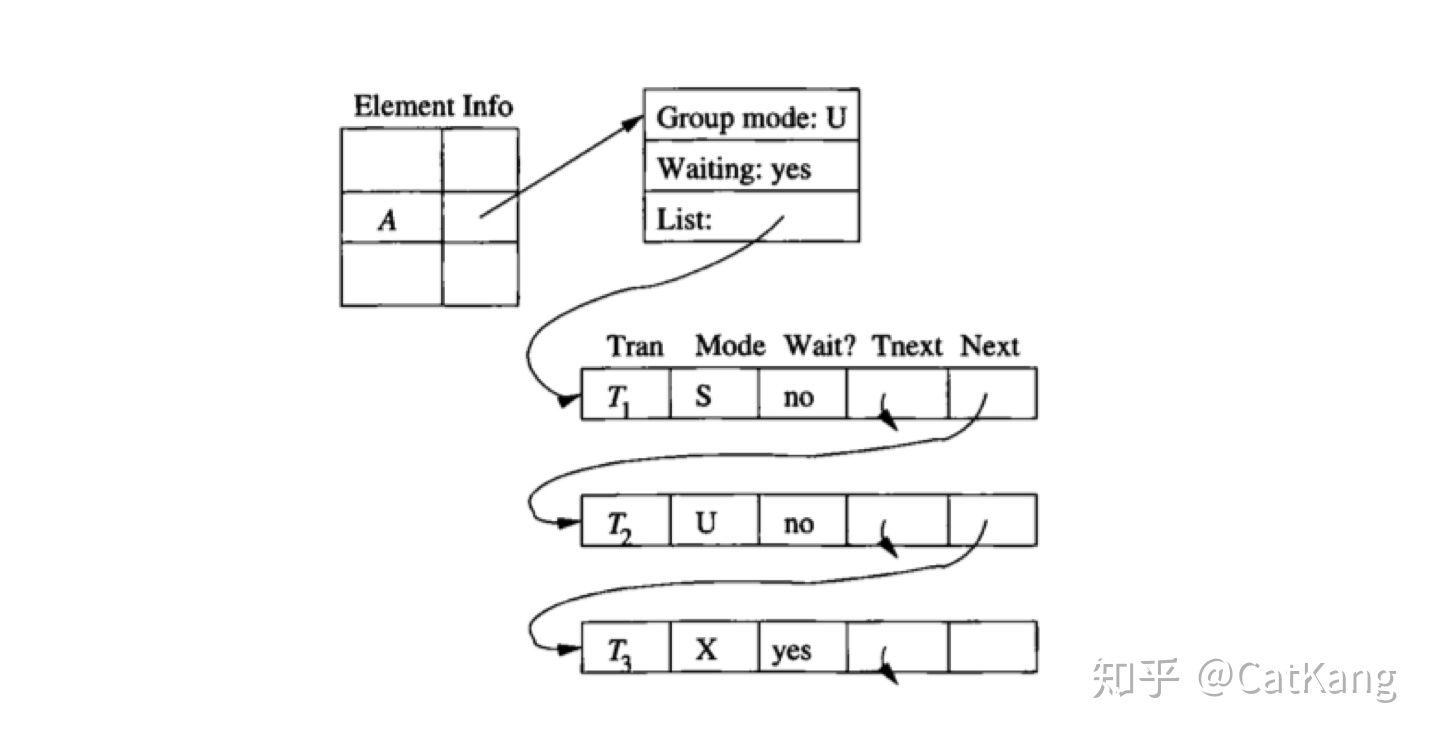
数据库通常会有一个调度模块来负责资源的加锁放锁,以及对应事务的等待或丢弃。所有的锁的持有和等待信息会记录在一张Lock Table中,调度模块结合当前的Lock Table中的状况和锁模式的兼容表来作出决策。比如:事务T3已经持有了元素A的写锁WL,导致事务T1和T2无法获得读锁SL,从而在队列中等待,直到T3结束释放WL后,调度模块再依次唤醒等待的事务。
这个过程中,对可能破坏数据正确性的冲突事务,调度器可能选择下面两种处理方式:
- Delay:延迟某个事务的执行到合法的时刻
- Abort:直接放弃事务的提交,并回滚该事务可能造成的影响
锁
锁的类型
- 锁,锁表、锁行; 读写锁、互斥锁。
- 谓词锁,它的加锁对象不属于特定的对象(例如表中的一行),它属于所有符合某些搜索条件的对象。比如间隙锁(Next-Key Locking)就是关于谓词锁的简化以及性能更好的一个实现。
工作原理
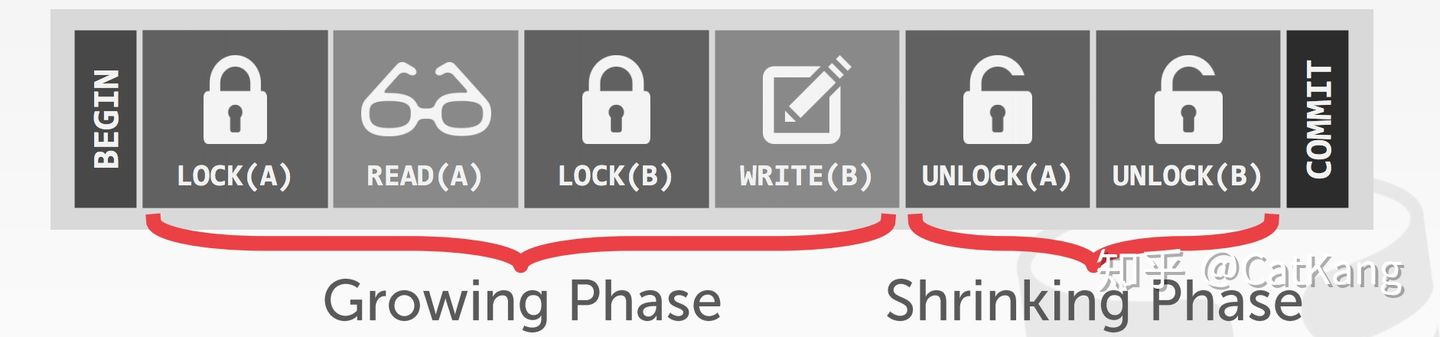
浅析数据库并发控制基于Lock实现的Scheduler需要在事务访问数据前加上必要的锁保护,为了提高并发,会根据实际访问情况分配不同模式的锁,常见的有读写锁,更新锁等。最简单地,需要长期持有锁到事务结束,为了尽可能的在保证正确性的基础上提高并行度,数据库中常用的加锁方式称为两阶段锁(2PL),Growing阶段可以申请加锁,Shrinking阶段只能释放,即在第一次释放锁之后不能再有任何加锁请求。需要注意的是2PL并不能解决死锁的问题,因此还需要有死锁检测及处理的机制,通常是选择死锁的事务进行Abort。PS:跟分布式事务有点一样
Scheduler对冲突的判断还需要配合Lock Table,如下图所示是一个可能得Lock Table信息示意,每一个被访问的数据库对象都会在Lock Table中有对应的表项,其中记录了当前最高的持有锁的模式、是否有事务在Delay、以及持有或等待对应锁的事务链表;同时对链表中的每个事务记录其事务ID,请求锁的模式以及是否已经持有该锁。Scheduler会在加锁请求到来时,通过查找Lock Table判断能否加锁或是Delay,如果Delay需要插入到链表中。对应的当事务Commit或Abort后需要对其持有的锁进行释放,并按照不同的策略唤醒等待队列中Delay的事务。PS:java 是将锁信息附着在对象header 上,但feel 是一样的
具体细节
InnoDB 事务锁源码分析InnoDB 中的lock是事务中对访问/修改的record加的锁,它一般是在事务提交或回滚时释放。latch是在BTree上定位record的时候对Btree pages加的锁,它一般是在对page中对应record加上lock并且完成访问/修改后就释放,latch的锁区间比lock小很多。在具体的实现中,一个大的transaction会被拆成若干小的mini transaction(mtr),如下图所示:有一个transaction,依次做了insert,select…for update及update操作,这3个操作分别对应3个mtr,每个mtr完成:
1. 在btree查找目标record,加相关page latch;
2. 加目标record lock,修改对应record
3. 释放page latch
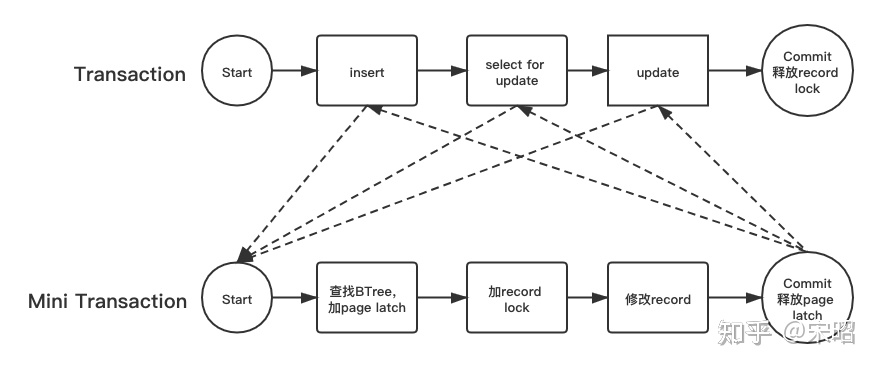
为什么latch的锁区间比lock小很多?是为了并发,事务中的每一个操作,在步骤二完成之后,相应的record已经加上了lock保护起来,确保其他并发事务无法修改,所以这时候没必要还占着record所在的page latch,否则其他事务 访问/修改 相同page的不同record时,这本来是可以并行做的事情,在这里会被page latch会被卡住。
RR支持可重复度,也就是在一个事务中,多次执行相同的SELECT…FOR UPDATE应该看到相同的结果集(除本事务修改外),这个就要求SELECT的区间里不能有其他事务插入新的record,所以SELECT除了对满足条件的record加lock之外,对相应区间也要加lock来保护起来。在InnoDB的实现中,并没有一个一下锁住某个指定区间的锁,而是把一个大的区间锁拆分放在区间中已有的多个record上来完成。所以引入了Gap lock和Next-key lock的概念,它们加再一个具体的record上
- Gap lock 保护这个record与其前一个record之间的开区间
- Next-key lock 保护包含这个record与其前一个record之间的左开右闭区间 它们都是为了保护这个区间不能被别的事务插入新的record,实现RR。
MVCC 为数据提供多个副本
工作原理
基于Timestamp的Scheduler会在事务开始时候分配一个全局自增的Timestamp,这个Timestamp通常由物理时间戳或系统维护的自增id产生,用于区分事务开始的先后。同时,每个数据库对象需要增加一些额外的信息(多像jvm 对象的header 的线程id),这些信息会由对应的事务在访问后更新,包括:
- RT(X): 最大的读事务的Timestamp
- WT(X): 最大的写事务的Timestamp
-
C(X): 最新修改的事务是否已经提交 基于Timestamp假设开始时Timestamp的顺序就是事务执行的顺序,当事务访问数据库对象时,通过对比事务自己的Timestamp和该对象的信息,可以发现与这种与开始顺序不一致的情况,并作出应对:
- Read Late:比自己Timestamp晚的事务在自己想要Read之前对该数据进行了写入,并修改了WT(X),此时会Read不一致的数据。
- Write Late: 比自己Timestamp晚的事务在自己想要Write之前读取了该数据,并修改了RT(X),如果继续写入会导致对方读到不一致数据。 这两种情况都是由于实际访问数据的顺序与开始顺序不同导致的,Scheduler需要对冲突的事务进行Abort。
- Read Dirty:通过对比C(X),可以发现是否看到的是已经Commit的数据,如果需要保证Read Commit,则需要Delay事务到对方Commit之后再进行提交。
实现细节
为了实现多版本的并发控制,需要给每个事务在开始时分配一个唯一标识TID,并对数据库对象增加以下信息:
- txd-id,创建该版本的事务TID
- begin-ts及end-ts分别记录该版本创建和过期时的事务TID
- pointer: 指向该对象其他版本的链表
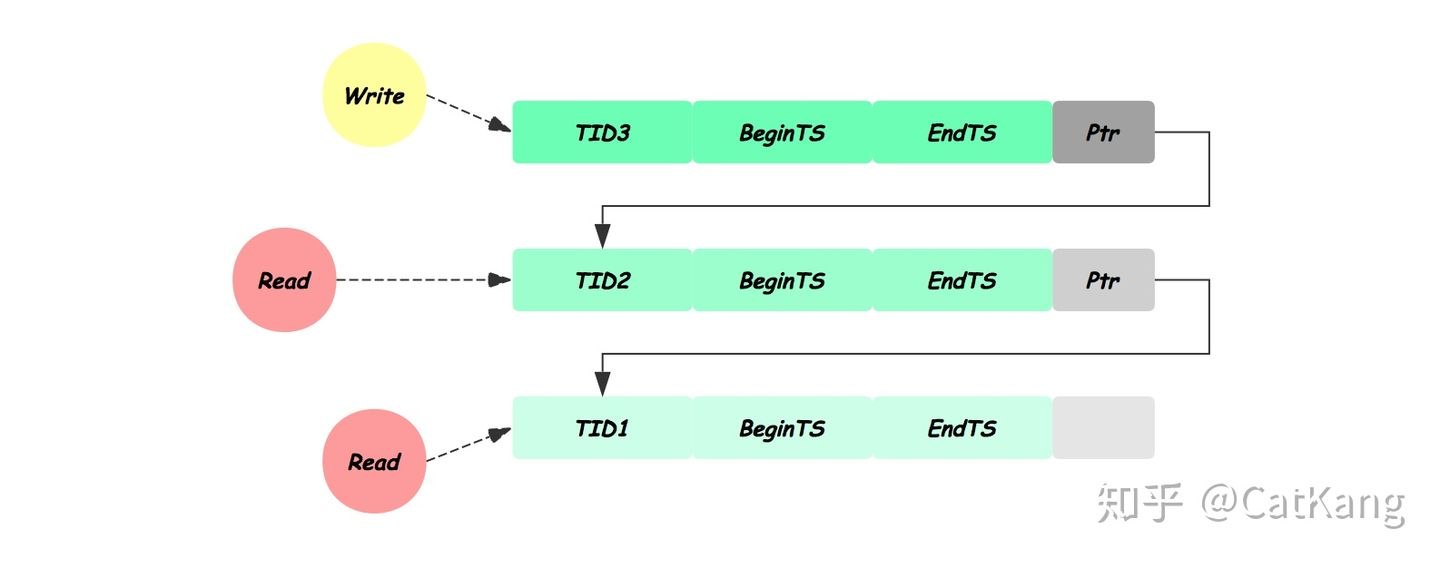
其基本的实现思路是,每次对数据库对象的写操作都生成一个新的版本,用自己的TID标记新版本begin-ts及上一个版本的end-ts,并将自己加入链表。读操作对比自己的TID与数据版本的begin-ts,end-ts,找到其可见最新的版本进行访问。根据乐观程度多版本的机制也分为三类:Two-phase Locking (MV2PL);Timestamp Ordering (MVTO);Optimistic Concurrency Control (MVOCC)
《MySQL实战45讲》一个事务要更新一行,如果刚好有另外一个事务拥有这一行的行锁,它又不能这么超然了,会被锁住,进入等待状态。问题是,既然进入了等待状态,那么等到这个事务自己获取到行锁要更新数据的时候,它读到的值又是什么呢?
begin/start transaction命令并不是一个事务的起点,在执行到它们之后的第一个操作 InnoDB 表的语句,事务才真正启动。如果你想要马上启动一个事务,可以使用start transaction with consistent snapshot这个命令。- 在 MySQL 里,有两个“视图”的概念
- 一个是 view。它是一个用查询语句定义的虚拟表,创建视图的语法是
create view …,而它的查询方法与表一样。 - 另一个是 InnoDB 在实现 MVCC 时用到的一致性读视图,即 consistent read view,用于支持 RC(Read Committed,读提交)和 RR(Repeatable Read,可重复读)隔离级别的实现。它没有物理结构,作用是事务执行期间用来定义“我能看到什么数据”。
- 一个是 view。它是一个用查询语句定义的虚拟表,创建视图的语法是
- 在可重复读隔离级别下,事务在启动的时候就“拍了个快照”。注意,这个快照是基于整库的。如果一个库有 100G,那么我启动一个事务,MySQL 就要拷贝 100G 的数据出来,这个过程得多慢啊。实际上,我们并不需要拷贝出这 100G 的数据。
- InnoDB 里面每个事务有一个唯一的事务 ID,叫作 transaction id。它是在事务开始的时候向 InnoDB 的事务系统申请的,是按申请顺序严格递增的。数据表中的一行记录,其实可能有多个版本 (row),每个版本有自己的 row trx_id(trx_id 即操作 row 的事务id)。一行记录的 多个版本并不是物理上真实存在的,而是每次需要的时候根据当前版本和 undo log 计算出来的
可重复读——可以读到什么数据
按照可重复读的定义,一个事务启动的时候,能够看到所有已经提交的事务结果。但是之后,这个事务执行期间,其他事务的更新对它不可见。在实现上, InnoDB 为每个事务构造了一个数组,用来保存这个事务启动瞬间,当前正在“活跃”的所有事务 ID。“活跃”指的就是,启动了但还没提交。数组里面事务 ID 的最小值记为低水位,当前系统里面已经创建过的事务 ID 的最大值加 1 记为高水位。
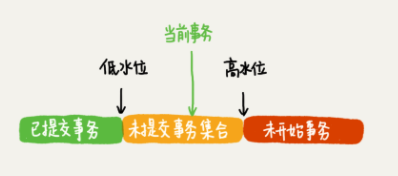
数据版本的可见性规则,就是基于数据的 row trx_id 和这个高低水位/事务视图(每个事务的高低水位都不同)对比结果得到的。对于当前事务的启动瞬间来说,一个数据版本的 row trx_id,有以下几种可能:
- 如果落在绿色部分,表示这个版本是已提交的事务或者是当前事务自己生成的,这个数据对当前事务是可见的;
- 如果落在红色部分,表示这个版本是由将来启动的事务生成的,是当前事务肯定不可见的;
- 如果落在黄色部分,那就包括两种情况:a 若 row trx_id 在数组中,表示这个版本是由还没提交的事务生成的,对当前事务不可见; b 若 row trx_id 不在数组中,表示这个版本是已经提交了的事务生成的,对当前事务可见。
有了这个声明后,系统里面随后发生的更新,是不是就跟这个事务看到的内容无关了呢?因为之后的更新,生成的版本一定属于上面的 2 或者 3(a) 的情况,而对它来说,这些新的数据版本是不存在的,所以这个事务的快照,就是“静态”的了。InnoDB 利用了“所有数据都有多个版本”的这个特性,实现了“秒级创建快照”的能力(PS:有点copy on write的feel)。一个数据版本,对于一个事务视图来说,除了自己的更新总是可见以外,有三种情况:
- 版本未提交,不可见;
- 版本已提交,但是是在视图创建后提交的,不可见;
- 版本已提交,而且是在视图创建前提交的,可见。
可重复读——更新逻辑
当事务要去更新数据的时候,就不能再在历史版本上更新了,否则其它事务的更新就丢失了。update 更新数据都是先读后写的,而这个读,只能读当前的值,称为“当前读”(current read):必须要读最新版本,而且必须加锁。当前读的规则,就是要能读到所有已经提交的记录的最新值。
如果当前记录的行锁被其他事务占用的话,就需要进入锁等待。根据两阶段锁协议,其他事务提交才会释放锁,因此可以读到其他事务提交后的row。
除了 update 语句外,select 语句如果加锁,也是当前读
# 加读锁
mysql> select k from t where id=1 lock in share mode;
# 加写锁
mysql> select k from t where id=1 for update;
mvcc 实现
postgresql、mysql、tidb对 mvcc 有着不同的实现方案。
TiKV 事务模型概览,Google Spanner 开源实现MVCC层暴露给上层的接口行为定义:
MVCCGet(key, version), 返回某 key 小于等于 version 的最大版本的值
MVCCScan(startKey, endKey, limit, version), 返回 [startKey, endKey) 区间内的 key 小于等于 version 的最大版本的键和值,上限 limit 个
MVCCPut(key, value, version) 插入某个键值对,如果 version 已经存在,则覆盖它。上层事务系统有责任维护自增version来避免read-modify-write
MVCCDelete(key, version) 删除某个特定版本的键值对, 这个需要与上层的事务删除接口区分,只有 GC 模块可以调用这个接口
读提交
读提交的逻辑和可重复读的逻辑类似,它们最主要的区别是:
- 在可重复读隔离级别下,只需要在事务开始的时候创建一致性视图(高低水位),之后事务里的其他查询都共用这个一致性视图;对于可重复读,查询只承认在事务启动前就已经提交完成的数据;
- 在读提交隔离级别下,每一个语句执行前都会重新算出一个新的视图(高低水位)。对于读提交,查询只承认在语句启动前就已经提交完成的数据;