serverless 泛谈
目录
简介
一篇讲Serverless 的文章有一个留言:Serverless是在服务网格架构之后进行业务逻辑层的改造。Serverless 的核心理念是按需使用,自动弹性。用户不需要容量规划。
为什么Serverless 会火
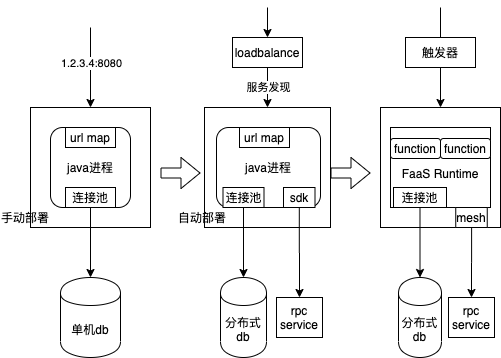
从用户视角看:托管node ==> 托管pod ==> 托管function。从实践上也是必须这样慢慢推进的,比如一家公司不用云厂商的对象存储、数据库,然后突然一步托管到function 是不可能的。Serverless 时代下微服务应用全托管解决方案微服务化给运维带来了很大的挑战:
- 效率:随着应用规模的扩张,新的研发团队需要面临很多开发和测试中的复杂性问题。在团队协作上,不同应用团队之间如何更好地形成稳定的调用链路,在几十,几百甚至上千个应用的大规模场景里如何进行调用链路上应用的快速部署和灰度。此外,如此多应用的流量的处理、调用链路的跟踪和服务鉴权也非常影响效率。
- 稳定:微服务化之后,会出现调用链路上某核心应用出现问题,导致整体系统发生雪崩,而且有时缺少可视化、可观测性的系统来帮助快速定位分析问题,导致难以快速定位到出现问题的应用,造成长时间的损失;
- 成本:单体应用一般只需部署几台机器;到了微服务时代,随着应用数的剧增,出于可用性的考虑需要为每个应用保持一些冗余,比如一次大促中,一个调用链路会涉及到十几个应用,为了稳定性以及调用链路的安全,会进行整个链路应用的扩容,而实际上很多应用可能长时间没有流量,服务器空闲,导致巨大的成本浪费。 面对微服务带来的这些问题和需求, Serverless 应用引擎在这方面都做了哪些工作? 带来哪些改变?PS:或者说,这些问题如果能得到比较妥善的解决,其实不用Serverless 也可以。
《Serverless入门课》
为什么阿里会上升到整个集团的高度来推进 Serverless 研发模式升级,对此,杜欢表示:“ 这件事本身好像是一件技术的事情,但其实它背后就是钱的事情,都是跟钱相关的。”
为什么阿里巴巴、腾讯这样的公司都在关注 ServerlessServerless 既可以满足资源最大化利用的需求,也能够调优行业内的开发岗位分层结构。
- Serverless 可以有效降低企业中中长尾应用的运营成本。中长尾应用就是那些每天大部分时间都没有流量或者有很少流量的应用。尤其是企业在落地微服务架构后,一些边缘的微服务被调用的概率其实很低。而这个时候,我们往往又很难通过人工来控制中长尾应用,因为这里面不少应用还是被强依赖的,不可以直接下线处理。Serverless 之前,这些中长尾应用至少要独占 1 台虚拟机;现在有了 Serverless 的极速冷启动特性,企业就可以节省这部分开销。PS:核心系统可能因为极致追求性能等 还是会“重型”开发,但对于小需求 确实可以用Serverless 来支撑。
- 其次,Serverless 可以提高研发效能。现有的研发形态并不能最大化地发挥部分工作岗位的价值,这同样是一种浪费。以导购类型的业务为例,开发这样一个业务通常需要前端开发工程师和后端开发工程师一起配合,但这两个开发岗位在该业务形态下并不能很好地发挥自己的全部价值。对于后端工程师来说,他在这个业务里要做的事情更多只是把现有的一些服务能力、数据组合在一起,变成一个新的数据提供给前端;而前端开发工程师负责把这个数据在页面上展示出来。这样的工作比较机械化,也没有太大的挑战,并不利于后端工程师的个人成长和岗位价值发挥;但在现有的研发模式下,由于缺乏前后端的连接点,前端工程师又不能去做这些比较简单的后端工作,业务上线也不可能给到前端工程师时间和机会去学习再实践。 Serverless 应用架构中,SFF(Serverless For Frontend)可以让前端同学自行负责数据接口的编排,微服务 BaaS 化则让我们的后端同学更加关注领域设计。可以说,这是一个颠覆性的变化,它能够进一步放大前端工程师的价值。
从技术演化看Serverless
Serverless 的喧哗与骚动(一):Serverless 行业发展简史
- 单机时代,操作系统管理了硬件资源,贴着资源层,高级语言让程序员描述业务,贴着业务层,编译器 /VM 把高级语言翻译成机器码,交给操作系统;
- 今天的云时代,资源的单位不再是 CPU、内存、硬盘了,而是容器、分布式队列、分布式缓存、分布式文件系统。就像从汇编语言发展到高级语言后,开发者不用再去关注寄存器、信号、中断等与机器底层相关的细节
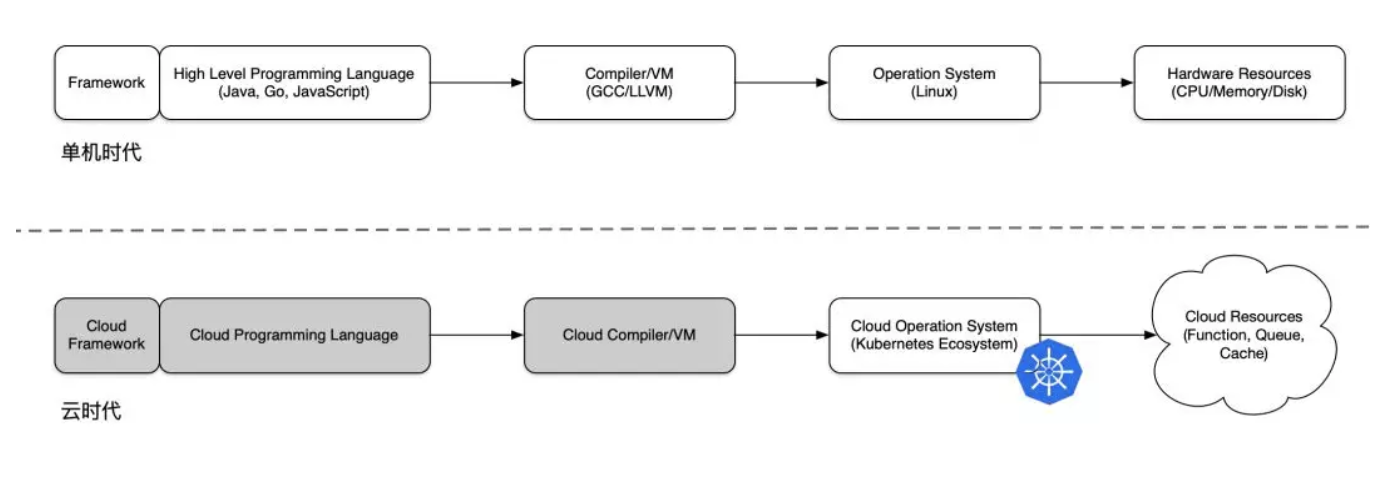
今天我们把应用程序往云上搬的时候(a.k.a Cloud Native),往往都会做两件事情:
- 把巨型应用拆小,微服务化;
- 摇身一变成为 yaml 工程师,写很多 yaml 文件来管理云上的资源。
这里存在两个巨大的 gap,这两个 gap 在图中用灰色的框表示了:
- 编程语言和框架,目前主流的编程语言基本都是假设单机体系架构运行的
- 编译器,程序员不应该花大量时间去写 yaml 文件,这些面向资源的 yaml 文件应该是由机器生成的,我称之为云编译器,高级编程语言用来表达业务的领域模型和逻辑,云编译器负责将语言编译成资源描述。
喧哗的背后:Serverless 的概念及挑战Docker 和 Kubernetes,其中前者标准化了应用分发的标准,不论是 Spring Boot 写的应用,还是 NodeJS 写的应用,都以镜像的方式分发;而后者在前者的技术上又定义了应用生命周期的标准,一个应用从启动到上线,到健康检查、下线,有了统一的标准。有了应用分发的标准和生命周期的标准,云就能提供标准化的应用托管服务,包括应用的版本管理、发布、上线后的观测、自愈等。例如对于无状态的应用来说,一个底层物理节点的故障根本就不会影响到研发,因为应用托管服务基于标准化应用生命周期可以自动完成腾挪工作,在故障物理节点上将应用的容器下线,在新的物理节点上启动同等数量的应用容器。在此基础上,由于应用托管服务能够感知到应用运行期的数据,例如业务流量的并发、CPU load、内存占用等,业务就可以配置基于这些指标的伸缩规则,由平台执行这些规则,根据业务流量的实际情况增加或者减少容器数量,这就是最基本的 auto scaling,自动伸缩。这就能够帮助用户避免在业务低峰期限制资源,节省成本,提升运维效率。PS: 应用分发的标准 + 应用生命周期的标准 ==> 标准化的应用托管服务 + 运行数据及流量监控 ==> auto scaling ==> 由平台系统管理机器,而不是由人去管理,这就是一个很朴素的 Serverless 理解。
如果我们把目光放到今天云的时代,那么就不能狭义地把 Serverless 仅仅理解成为不用关心服务器。云上的资源除了服务器所包含的基础计算、网络、存储资源之外,还包括各种类别的更上层的资源,例如数据库、缓存、消息等等。我们今天主流的使用云的方式不应该是未来我们使用云的方式。我认为 Serverless 的愿景应该是 Write locally, compile to the cloud,即代码只关心业务逻辑,由工具和云去管理资源。PS:这时候就又提到sql,代码就如同sql 只负责表达业务(描述做什么)而不关心怎么做。
云原生运行时的下一个五年:函数是不是下一站? 非常不错。
从 Docker 讲起,深度揭秘阿里云 Serverless Kubernetes无论是 k8s 还是 ServiceMesh,都在分别尝试将服务管理和流量管理下沉到基础设施中。但这些组件本身也存在管理成本,所以演化出云上托管。用户从云平台获取一个 kubeconfig 文件便可以直接通过 kubectl 命令行或者 Restful API 管理集群。再进一步,如果集群里面运行任务大部分都是 long run 并且资源需求是固定的任务,使用 ACK 没有问题,但如果是大量 job 类型的任务或者存在突发流量的情况,ACK 这种临时扩容虚拟机在虚拟机上启用容器方案在弹性方面有所欠缺。那么,有没有一种既能兼容 Kubernetes 使用方式,又能够秒级启动 Pod,并且按照 Pod 维度计费(ACK 按照 Node 维度计费)的方案呢?
Serverfull vs Serverless
Serverfull 就是服务端运维全由我们自己负责,Serverless 则是服务端运维较少由我们自己负责,大多数的运维工作交给自动化工具负责。
- 农耕时代,发布+看日志等工具化
- 工业时代,资源优化和扩缩容方案也可以利用性能监控 + 流量估算解决;代码自动化发布的流水线:代码扫描 - 测试 - 灰度验证 - 上线。
免运维 NoOps 并不是说服务端运维就不存在了,而是通过全知全能的服务,覆盖研发部署需要的所有需求,让研发同学对运维的感知越来越少。另外,NoOps 是理想状态,因为我们只能无限逼近 NoOps,所以这个单词是 less,不可能是 ServerLeast 或者 ServerZero。
- 狭义 Serverless(最常见)= Serverless computing 架构 = FaaS 架构 = Trigger(事件驱动)+ FaaS(函数即服务)+ BaaS(后端即服务,持久化或第三方服务)= FaaS + BaaS
- 广义 Serverless = 服务端免运维 = 具备 Serverless 特性的云服务
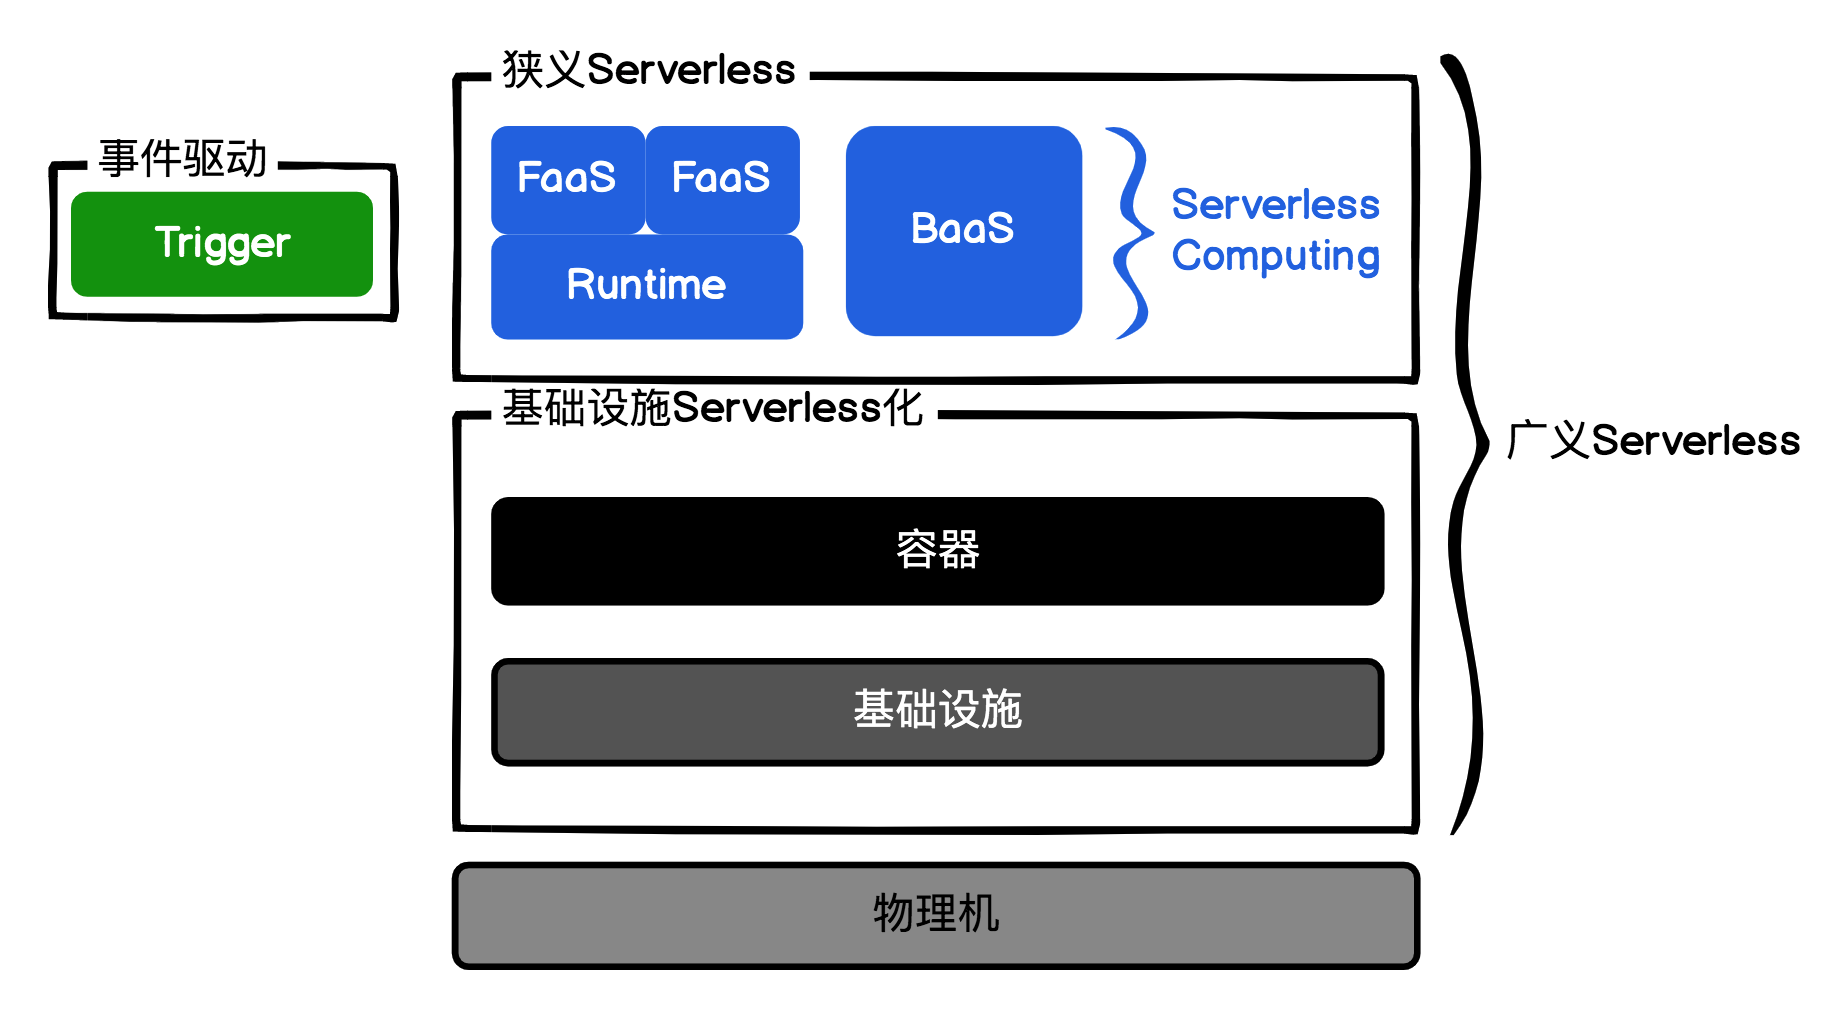
喧哗的背后:Serverless 的概念及挑战虽然说是 Serverless,但 Server(服务器)是不可能真正消失的,Serverless 里这个 less 更确切的说是开发不用关心的意思。这就好比现代编程语言 Java 和 Python,开发就不用手工分配和释放内存了,但内存还在哪里,只不过交给垃圾收集器管理了。称一个能帮助你管理服务器的平台为 Serverless 平台,就好比称呼 Java 和 Python 为 Memoryless 语言一样。
这里讲下笔者的一个体会,一开始在公司内搞容器化,当时觉得只要把应用以容器的方式跑起来就可以了(应用托管平台)。一开始拿测试环境试验容器化,运维把测试环境的维护工作完全交给 容器团队。这时,天天干的一个活儿是 给web 开发配域名,为此后来针对域名配置定义了一套规范、 开发了一个nginx插件自动化了(引入了网关之后,改为自动更新网关接口)。这个过程其实就是 less 的过程。
从Kubernetes 到Serverless
Knative Serverless 之道:如何 0 运维、低成本实现应用托管?计算、存储和网络这三个核心要素已经被 Kubernetes 层统一了,Kubernetes 已经提供了 Pod 的无服务器支持,而应用层想要用好这个能力其实还有很多事情需要处理。
- 弹性:缩容到零;突发流量
- 灰度发布:如何实现灰度发布;灰度发布和弹性的关系
- 流量管理:灰度发布的时候如何在 v1 和 v2 之间动态调整流量比例;流量管理和弹性是怎样一个关系;当有突发流量的时候如何和弹性配合,做到突发请求不丢失
我们发现虽然基础资源可以动态申请,但是应用如果要做到实时弹性、按需分配和按量付费的能力还是需要有一层编排系统来完成应用和 Kubernetes 的适配。这个适配不单单要负责弹性,还要有能力同时管理流量和灰度发布。
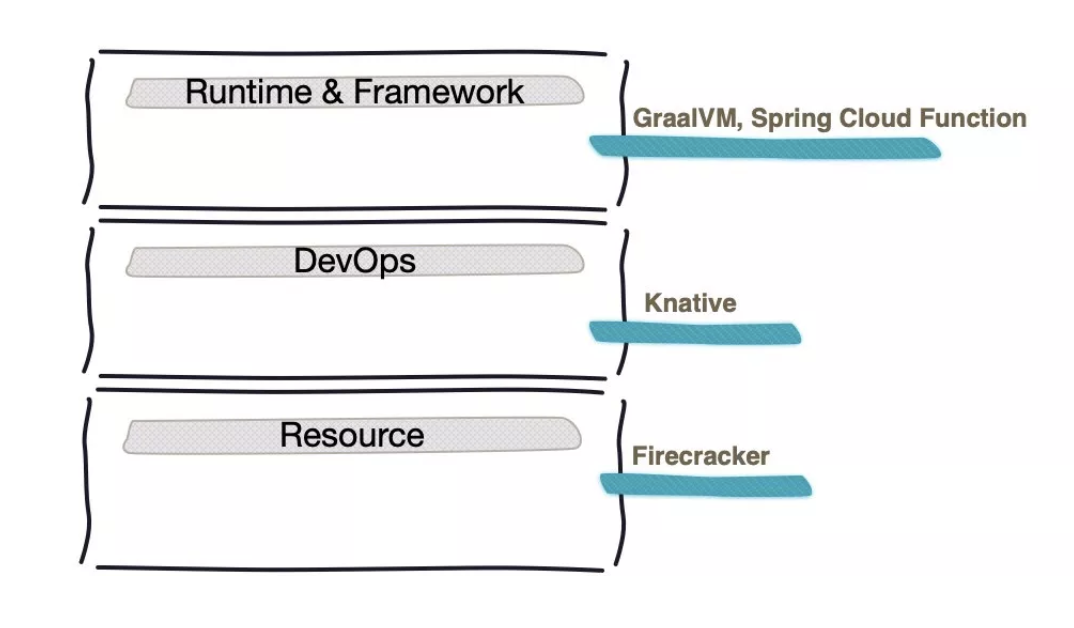
- 资源层关注的是资源(如容器)的生命周期管理,以及安全隔离。这里是 Kubernetes 的天下,Firecracker,gVisor 等产品在做轻量级安全沙箱。这一层关注的是如何能够更快地生产资源,以及保证好安全性。
-
DevOps 层关注的是变更管理、流量调配以及弹性伸缩,还包括基于事件模型和云生态打通。这一层的核心目标是如何把运维这件事情给做没了(NoOps)。虽然所有云厂商都有自己的产品(各种 FaaS),但是我个人比较看好 Knative 这个开源产品,原因有二:
- 其模型非常完备;
- 其生态发展非常迅速和健康。很有可能未来所有云厂商都要去兼容 Knative 的标准,就像今天所有云厂商都在兼容 Kubernetes 一样。
- 框架和运行时层呢,由于个人经验所限,我看的仅仅是 Java 领域,其实核心的还是在解决 Java 应用程序启动慢的问题(GraalVM)。当然框架如何避免 vendor lock-in 也很重要,谁都怕被一家云厂商绑定,怕换个云厂商要改代码,这方面主要是 Spring Cloud Function 在做。
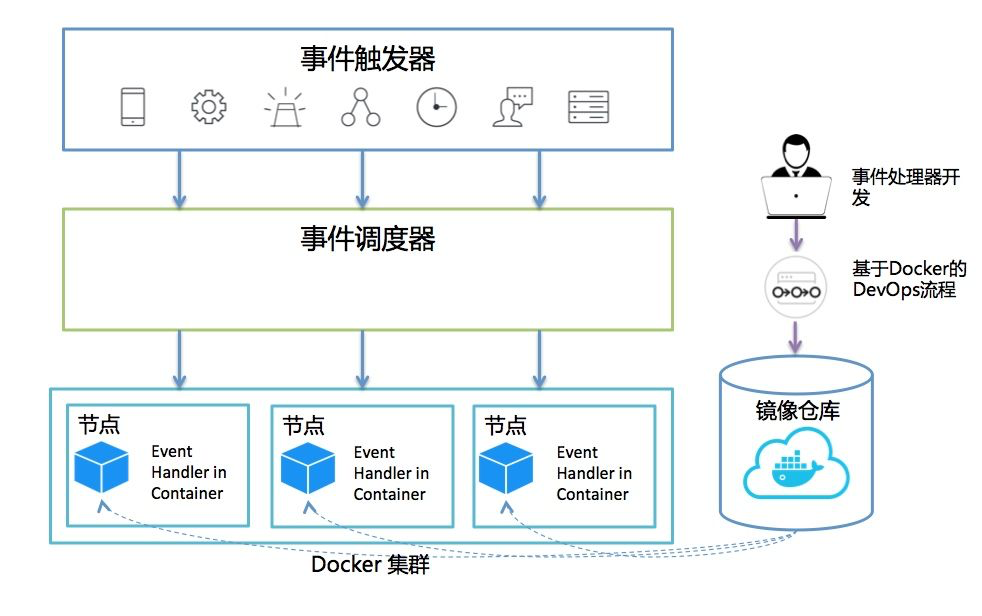
手感/Knative
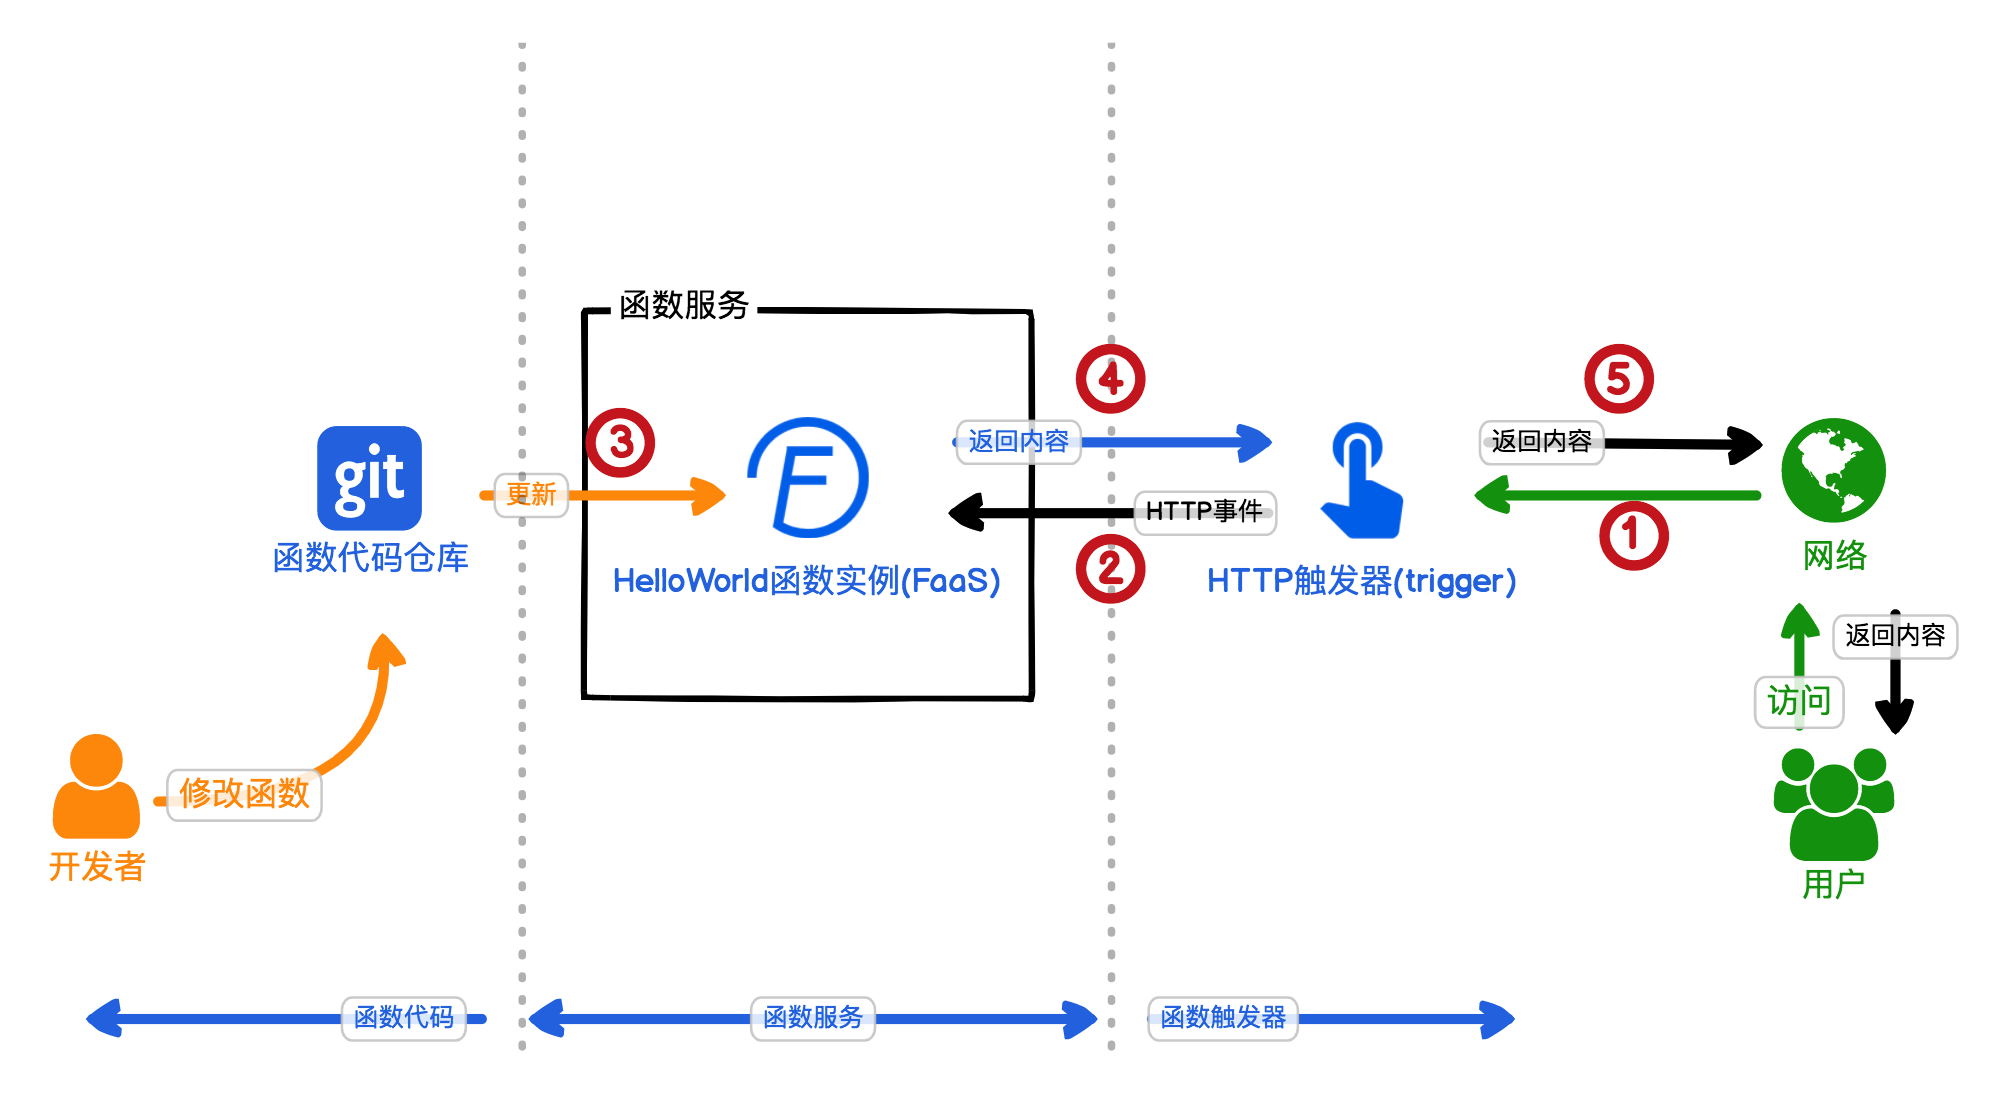
| 物理机时代 | Serverless | |
|---|---|---|
| 运行环境 | 在服务端构建代码的运行环境 | FaaS 应用将这一步抽象为函数服务 |
| 入口 | 负载均衡和反向代理 | FaaS 应用将这一步抽象为 HTTP 函数触发器 |
| 上传代码和启动应用 | FaaS 应用将这一步抽象为函数代码 |
Knative 作为最流行的应用 Severlesss 编排引擎,其中一个核心能力就是其简洁、高效的应用托管服务。Knative 提供的应用托管服务可以让您免去维护底层资源的烦恼,提升应用的迭代和服务交付效率。
- Build构建系统/Tekton:把用户定义的应用构建成容器镜像,面向kubernetes的标准化构建,区别于Dockerfile镜像构建,重点解决kubernetes环境的构建标准化问题。
-
Serving服务系统:利用Istio的部分功能,来配置应用路由,升级以及弹性伸缩。Serving中包括容器生命周期管理,容器外围对象(service,ingres)生成(恰到好处的把服务实例与访问统一在一起),监控应用请求,自动弹性负载,并且利用Virtual service和destination配置服务访问规则,流量、灰度(版本)和弹性这三者是完美契合在一起的。PS: Service 与普通workload 并无多大区别,结合了istio,你不用为服务配置port 等体现Server的概念
apiVersion: serving.knative.dev/v1alpha1 kind: Service metadata: name: stock-service-example namespace: default spec: template: metadata: name: stock-service-example-v2 annotations: autoscaling.knative.dev/class: "kpa.autoscaling.knative.dev" # 自动扩缩容 spec: containers: - image: registry.cn-hangzhou.aliyuncs.com/knative-sample/rest-api-go:v1 env: - name: RESOURCE value: v2 readinessProbe: httpGet: path: / initialDelaySeconds: 0 periodSeconds: 3 traffic: # 流量管理 - tag: v1 revisionName: stock-service-example-v1 percent: 50 - tag: v2 revisionName: stock-service-example-v2 percent: 50 - Eventing事件系统:用于自动完成事件的绑定与触发。事件系统与直接调用最大的区别在于响应式设计,它允许运行服务本身不需要屏蔽了调用方与被调用方的关系。从而在业务层面能够实现业务的快速聚合,或许为后续业务编排创新提供事件。PS:这块还感受不到价值
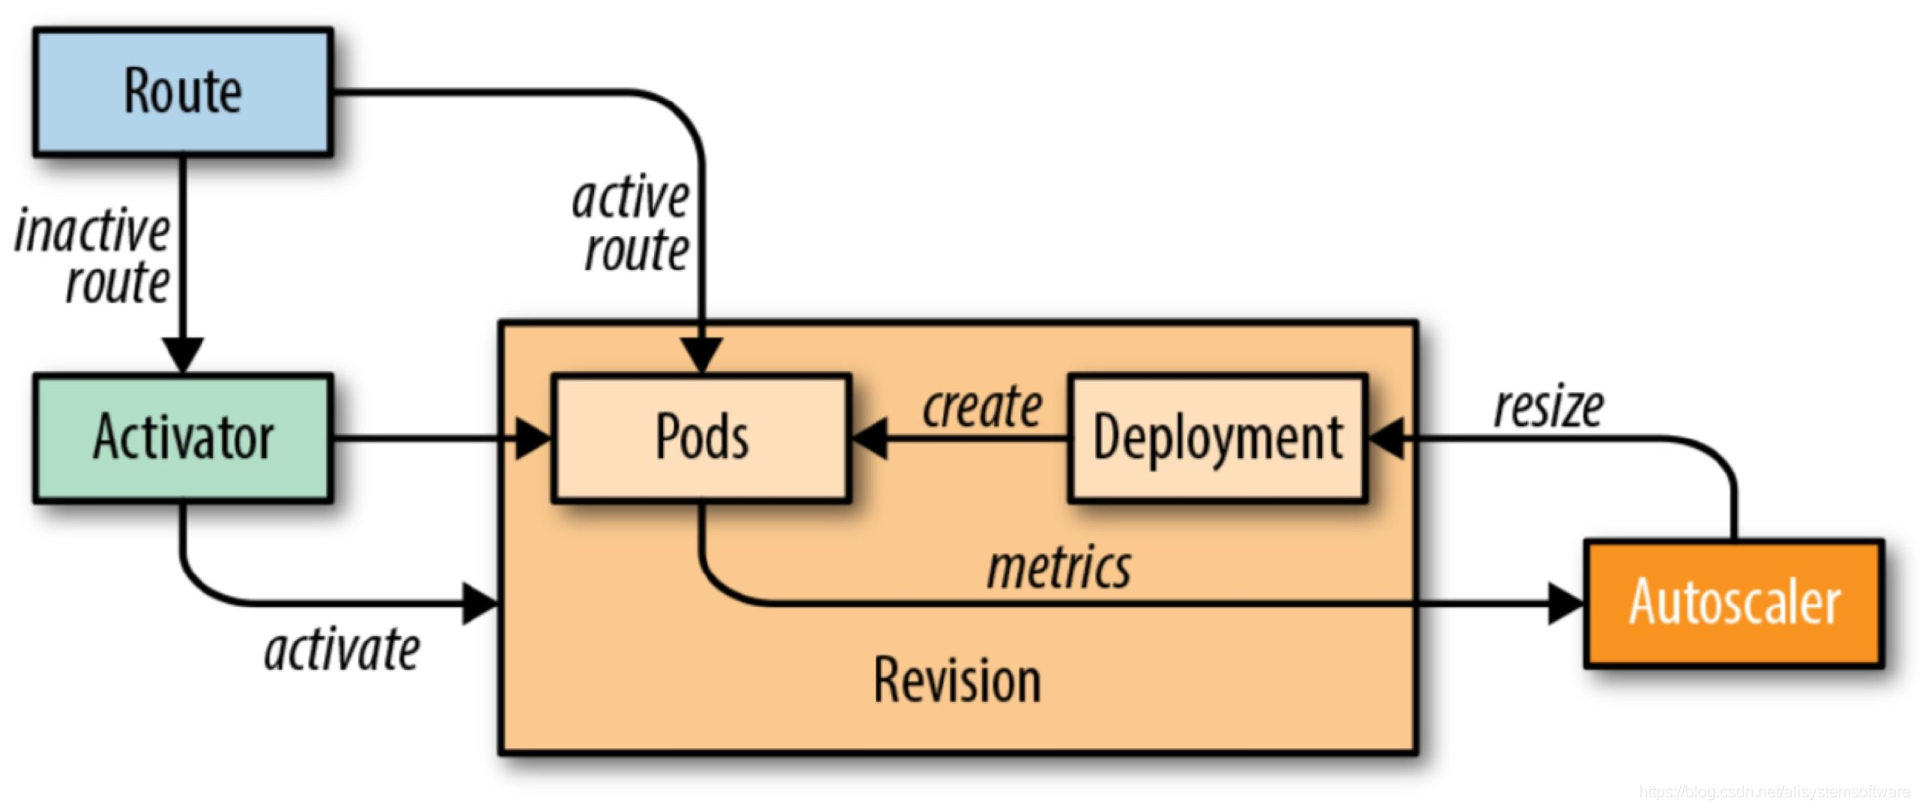
客户端请求通过入口网关转发给Activator(此时pod实例数为0),Activator汇报指标给Autoscaler,Autoscaler创建Deployment进而创建Pod,一旦Pod Ready,Activator会将缓存的客户端请求转发给对应的Pod,网关也会将新的请求直接转发给响应的Pod。当一定周期内没有请求时,Autoscaler会将Pod replicas设置为0,同时网关将后续请求路由到Activator。 PS:可以缩容到0是因为有一个常驻的Activator
与FaaS的关系
Serverless不等价于FaaS。也有人故意划分为Functions Serverless和容器化的Serverless。
FaaS 与应用托管 PaaS(应用托管平台) 平台对比,最大的区别在于资源利用率,这也是 FaaS 最大的创新点。FaaS 的应用实例可以缩容到 0,而应用托管 PaaS 平台则至少要维持 1 台服务器或容器。FaaS 优势背后的关键点是可以极速启动,现在的云服务商,基于不同的语言特性,冷启动平均耗时基本在 100~700 毫秒之间。
为什么 FaaS 可以极速启动,而应用托管平台 PaaS 不行?PaaS 为了适应用户的多样性,必须支持多语言兼容,还要提供传统后台服务,例如 MySQL、Redis。这也意味着,应用托管平台 PaaS 在初始化环境时,有大量依赖和多语言版本需要兼容,而且兼容多种用户的应用代码往往也会增加应用构建过程的时间。所以通常应用托管平台 PaaS 无法抽象出轻量的可复用的层级,只能选择服务器或容器方案,从操作系统层开始构建应用实例。FaaS 设计之初就牺牲了用户的可控性和应用场景,来简化代码模型,并且通过分层结构进一步提升资源的利用率。
关于 FaaS 的 3 层结构,你可以这么想象:容器层就像是 Windows 操作系统;Runtime 就像是 Windows 里面的播放器暴风影音;你的代码就像是放在 U 盘里的电影。
其它
Serverless 架构和之前的架构相比,最大的差异是:业务服务不再是固定的常驻进程,而是真正按需启动和关闭的服务实例。
如果基础设施和相关服务不具备实时扩缩容的能力,那么业务整体就不是弹性的。
无服务器已死?这项技术为什么变得人人嫌弃一个良好运行的单体应用或许不应变成一个连接到八个网关、四十个队列和数十个数据库实例的一系列”函数“。因此,无服务器适用于那些尚未开发的领域。几乎没有将现有应用(架构)移植过来的案例。
距离 Java 开发者玩转 Serverless,到底还有多远?
云原生体系下 Serverless 弹性探索与实践 几个收获
- 互联网企业往往由于其内部应用具有显著流量特征,应用启动依赖多,速度慢,且对整体资源池容量水位,库存财务管理,离在线混部有组织上的诸多诉求,因而更多的是以容量画像提前弹性扩容为主,基于 Metrics 计算的容量数据作为实时修正,其目标是容量画像足够精准以至于资源利用率达到预期目标。公有云厂商服务于外部客户,提供更为通用,普适的能力,并通过可拓展性满足不同用户的差异化需求。尤其在 Serverless 场景,更强调应用应对突发流量的能力,其目标在于无需容量规划,通过指标监控配合极致弹性能力实现应用资源的近乎按需使用且整个过程服务可用。PS:互联网行业的服务可能秒级启动做不到。
- 原地升级给 SAE 带来了诸多价值,其中最重要的是避免重调度,避免 Sidecar 容器(ARMS,SLS,AHAS)重建,使得整个部署耗时从消耗整个 Pod 生命周期到只需要拉取和创建业务容器,于此同时因为无需调度,可以预先在 Node 上缓存新镜像 (PS:镜像push后知道往哪推了),提高弹性效率。SAE 采用阿里开源 Openkruise 项目提供的 Cloneset 作为新的应用负载,借助其提供的原地升级能力,使得整个弹性效率提升 42%。PS:没想到原地升级这么重要
- 对于 Java 应用冷启动较慢的痛点,SAE 联合 Dragonwell 11 提供了增强的 AppCDS 启动加速策略,AppCDS 即 Application Class Data Sharing,通过这项技术可以获取应用启动时的 Classlist 并 Dump 其中的共享的类文件,当应用再次启动时可以使用共享文件来启动应用,进而有效减少冷启动耗时