Goroutine 调度过程
目录
前言
本文内容来自 张万波大佬 go语言调度器源代码情景分析。在此再次表达 对大佬的膜拜。
预备知识
系统调用是指使用类似函数调用的方式调用操作系统提供的API。虽然从概念上来说系统调用和函数调用差不多,但本质上它们有很大的不同(call vs int/syscall)
- 操作系统的代码位于内核地址空间,而CPU在执行用户代码时特权等级很低,无权访问需要最高优先级才能访问的内核地址空间的代码和数据,所以不能通过简单的call指令直接调用操作系统提供的函数,而需要使用特殊的指令进入操作系统内核完成指定的功能。
- 用户代码调用操作系统API不是根据函数名直接调用,而是需要根据操作系统为每个API提供的一个整型编号来调用,AMD64 Linux平台约定在进行系统调用时使用rax寄存器存放系统调用编号(PS:还有专门的寄存器),同时约定使用rdi, rsi, rdx, r10, r8和r9来传递前6个系统调用参数。
- 函数调用只需要切换PC 及栈寄存器等几个寄存器,系统调用则涉及到整个cpu上下文(所有寄存器)的切换。不过并不会涉及到虚拟内存等进程用户态的资源,也不会切换进程。系统调用属于同进程内的 CPU 上下文切换,进程的上下文切换就比系统调用时多了一步:在保存内核态资源(当前进程的内核状态和 CPU 寄存器)之前,需要先把该进程的用户态资源(虚拟内存、栈等)保存下来;而加载了下一进程的内核态后,还需要刷新进程的虚拟内存和用户栈。
线程调度:操作系统什么时候会发起调度呢?总体来说操作系统必须要得到CPU的控制权后才能发起调度,那么当用户程序在CPU上运行时如何才能让CPU去执行操作系统代码从而让内核获得控制权呢?一般说来在两种情况下会从执行用户程序代码转去执行操作系统代码:
- 用户程序使用系统调用进入操作系统内核;
- 硬件中断。硬件中断处理程序由操作系统提供,所以当硬件发生中断时,就会执行操作系统代码。硬件中断有个特别重要的时钟中断,这是操作系统能够发起抢占调度的基础。
源码分析
程序=数据结构 + 算法。调度器就是 基于 g/p/m/sched 等struct,提供初始化方法 schedinit ==> mcommoninit –> procresize –> newproc,代码go 生产g,在每个m 执行执行 mstart => mstart1 ==> schedule 来消费g。PS: 不一定对,这个表述手法很重要。
go main 函数执行
Go 语言设计与实现 Goroutinelinux amd64系统的启动函数是在asm_amd64.s的runtime·rt0_go函数中。
// go/1.15.2/libexec/src/runtime/asm_amd64.s
TEXT runtime·rt0_go(SB),NOSPLIT,$0
	...
	CALL	runtime·args(SB)            // 初始化执行文件的绝对路径
	CALL	runtime·osinit(SB)          // 初始化 CPU 个数和内存页大小
	CALL	runtime·schedinit(SB)       // 调度器初始化
	// 创建一个新的 goroutine 来启动程序
	MOVQ	$runtime·mainPC(SB), AX		// entry
	CALL	runtime·newproc(SB)         // 新建一个 goroutine,该 goroutine 绑定 runtime.main
	CALL	runtime·mstart(SB)          // 启动M,开始调度goroutine/调度循环
	...
调度初始化
func schedinit() {
	...
	_g_ := getg()
	...
	sched.maxmcount = 10000     // 最大线程数10000
	mcommoninit(_g_.m, -1)      // M0 初始化
	...
	gcinit()                    // 垃圾回收器初始化
	sched.lastpoll = uint64(nanotime())
	procs := ncpu               // 通过 CPU 核心数和 GOMAXPROCS 环境变量确定 P 的数量
	if n, ok := atoi32(gogetenv("GOMAXPROCS")); ok && n > 0 {
		procs = n
	}
    // P 初始化
	if procresize(procs) != nil {
		throw("unknown runnable goroutine during bootstrap")
	}
    ...
}
goroutine 创建
go 关键字在编译期间通过 stmt 和 call 两个方法将该关键字转换成 newproc 函数调用,代码的路径和原理与 defer 关键字几乎完全相同。我们向 newproc 中传入一个表示函数的指针 funcval,在这个函数中我们还会获取当前调用 newproc 函数的 Goroutine 以及调用方的程序计数器 PC,然后调用 newproc1 函数:
// $GOROOT/src/runtime/proc.go
func newproc(siz int32, fn *funcval) {
    argp := add(unsafe.Pointer(&fn), sys.PtrSize)
    gp := getg()    // 获取当前的 G
    pc := getcallerpc()
    newproc1(fn, (*uint8)(argp), siz, gp, pc)
}
newproc1 函数的主要作用就是创建一个运行传入参数 fn 的 g 结构体,并对其各个成员赋值。
func newproc1(fn *funcval, argp *uint8, narg int32, callergp *g, callerpc uintptr) {
    _g_ := getg()
    siz := narg
    siz = (siz + 7) &^ 7
    _p_ := _g_.m.p.ptr()
    // 获取或创建一个 g struct
    newg := gfget(_p_)
    if newg == nil {
        newg = malg(_StackMin)
        casgstatus(newg, _Gidle, _Gdead)
        allgadd(newg)
    }
    // 获取新创建 Goroutine 的堆栈并直接通过 memmove 将函数 fn 需要的参数全部拷贝到栈中
    totalSize := 4*sys.RegSize + uintptr(siz) + sys.MinFrameSize
    totalSize += -totalSize & (sys.SpAlign - 1)
    sp := newg.stack.hi - totalSize
    spArg := sp
    if narg > 0 {
        memmove(unsafe.Pointer(spArg), unsafe.Pointer(argp), uintptr(narg))
    }
    // 初始化新 Goroutine 的栈指针、程序计数器、调用方程序计数器等属性
    memclrNoHeapPointers(unsafe.Pointer(&newg.sched), unsafe.Sizeof(newg.sched))
    newg.sched.sp = sp
    newg.stktopsp = sp
    newg.sched.pc = funcPC(goexit) + sys.PCQuantum
    newg.sched.g = guintptr(unsafe.Pointer(newg))
    gostartcallfn(&newg.sched, fn)
    newg.gopc = callerpc
    newg.startpc = fn.fn
    if isSystemGoroutine(newg, false) {
        atomic.Xadd(&sched.ngsys, +1)
    }
    // 将新 Goroutine 的状态从 _Gdead 切换成 _Grunnable 并设置 Goroutine 的标识符(goid)
    casgstatus(newg, _Gdead, _Grunnable)

    newg.goid = int64(_p_.goidcache)
    _p_.goidcache++
    // runqput 函数会将新的 Goroutine 添加到处理器 P 的运行队列上
    runqput(_p_, newg, true)
    // 如果符合条件,当前函数会通过 wakep 来添加一个新的 p 结构体来执行 Goroutine
    if atomic.Load(&sched.npidle) != 0 && atomic.Load(&sched.nmspinning) == 0 && mainStarted {
        wakep() // 唤醒新的  P 执行 G
    }
}
有哪些调度入口
协程切换的原因一般有以下几种情况:
- 系统调用;Go 语言通过 Syscall 和 Rawsyscall 等使用汇编语言编写的方法封装了操作系统提供的所有系统调用
- 同步和编排;如果原子、互斥量或通道操作调用将导致 Goroutine 阻塞,调度器可以将之切换到一个新的 Goroutine 去运行。一旦 Goroutine 可以再次运行,它就可以重新排队,并最终在M上切换回来。
- 抢占式调度时间片结束;
- 垃圾回收
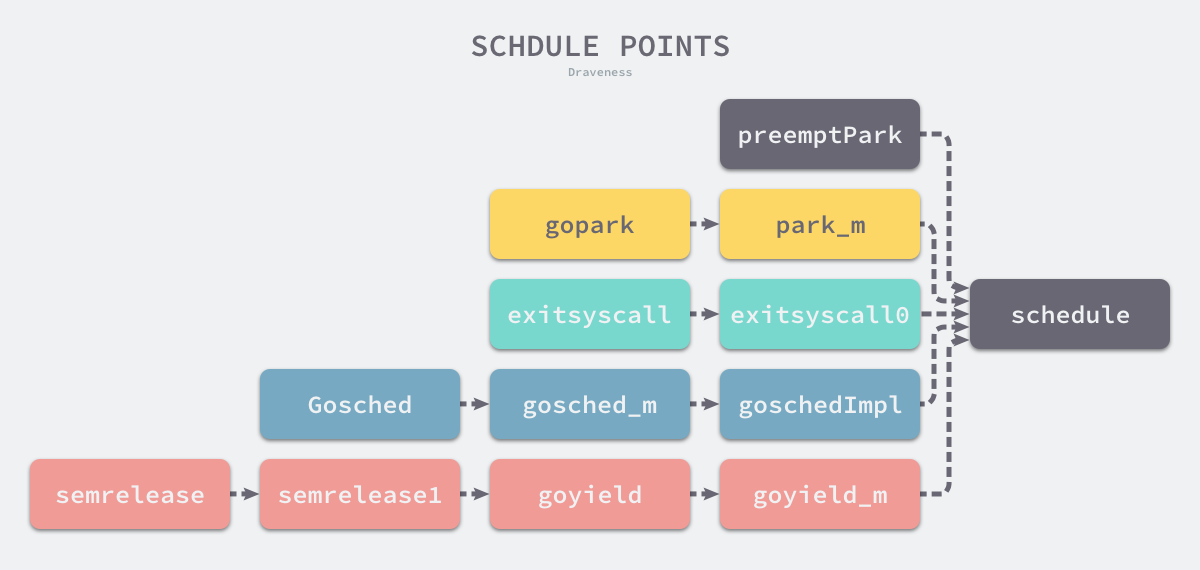
就好像linux 进程会主动调用schedule() 触发调度让出cpu 控制权,只是linux 多了时间片中断主动触发调度而已。
func gopark(unlockf func(*g, unsafe.Pointer) bool, lock unsafe.Pointer, reason waitReason, traceEv byte, traceskip int) {
    mp := acquirem()
    gp := mp.curg
    mp.waitlock = lock
    mp.waitunlockf = unlockf
    gp.waitreason = reason
    mp.waittraceev = traceEv
    mp.waittraceskip = traceskip
    releasem(mp)
    mcall(park_m)
}
gopark 函数中会更新当前处理器(mp)的状态并在处理器上设置该 Goroutine 的等待原因。gopark中调用的 park_m 函数会将当前 Goroutine 的状态从 _Grunning 切换至 _Gwaiting 并调用 waitunlockf 函数进行解锁
func park_m(gp *g) {
    _g_ := getg()
    casgstatus(gp, _Grunning, _Gwaiting)
    dropg()
    if fn := _g_.m.waitunlockf; fn != nil {
        ok := fn(gp, _g_.m.waitlock)
        _g_.m.waitunlockf = nil
        _g_.m.waitlock = nil
        if !ok {
            casgstatus(gp, _Gwaiting, _Grunnable)
            execute(gp, true) // Schedule it back, never returns.
        }
    }
    schedule()
}
切换过程 schedule()
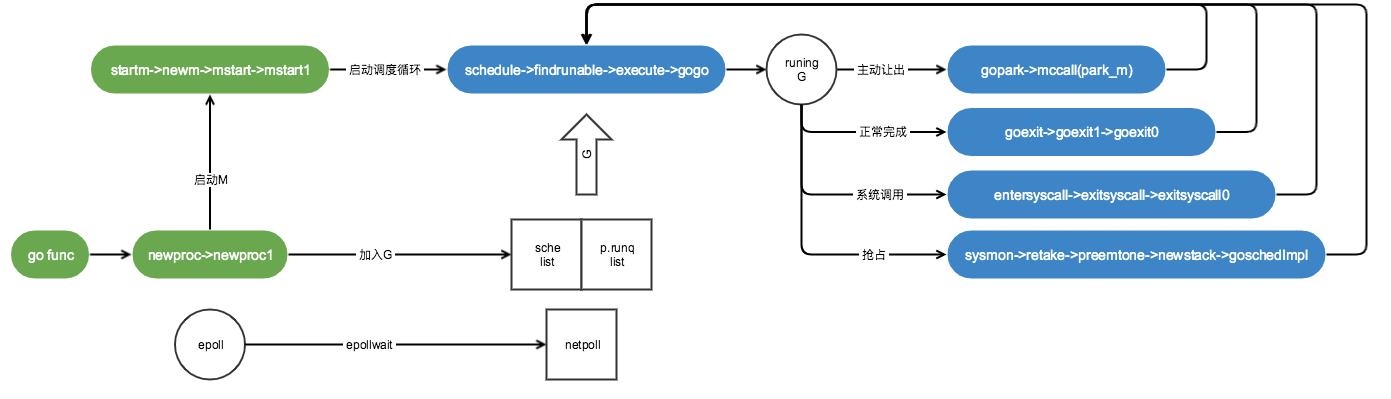
在大多数情况下都会调用 schedule 触发一次 Goroutine 调度,这个函数的主要作用就是从不同的地方查找待执行的 Goroutine:
func schedule() {
    _g_ := getg()
top:
    var gp *g
    var inheritTime bool
    // 有一定几率会从全局的运行队列中选择一个 Goroutine;为了保证调度的公平性,每个工作线程每进行61次调度就需要优先从全局运行队列中获取goroutine出来运行,因为如果只调度本地运行队列中的goroutine,则全局运行队列中的goroutine有可能得不到运行
    if gp == nil {
        if _g_.m.p.ptr().schedtick%61 == 0 && sched.runqsize > 0 {
            lock(&sched.lock)
            gp = globrunqget(_g_.m.p.ptr(), 1)
            unlock(&sched.lock)
        }
    }
    // 从当前处理器本地的运行队列中查找待执行的 Goroutine;
    if gp == nil {
        gp, inheritTime = runqget(_g_.m.p.ptr())
        if gp != nil && _g_.m.spinning {
            throw("schedule: spinning with local work")
        }
    }
    // 尝试从其他处理器上取出一部分 Goroutine,如果没有可执行的任务就会阻塞直到条件满足;
    if gp == nil {
        gp, inheritTime = findrunnable()  // 阻塞地查找可用G
    }
    // 执行G任务函数
    execute(gp, inheritTime)
}
findrunnable 函数会再次从本地运行队列、全局运行队列、网络轮询器和其他的处理器中偷取/获取待执行的任务,该方法一定会返回待执行的 Goroutine,否则就会一直阻塞。获取可以执行的任务之后就会调用 execute 函数执行该 Goroutine,执行的过程中会先将其状态修改成 _Grunning、与线程 M 建立起双向的关系并调用 gogo 触发调度。
func execute(gp *g, inheritTime bool) {
    _g_ := getg()
    // 将 g 正式切换为 _Grunning 状态
    casgstatus(gp, _Grunnable, _Grunning)
    gp.waitsince = 0
    // 抢占信号
    gp.preempt = false
    gp.stackguard0 = gp.stack.lo + _StackGuard
    if !inheritTime {
        _g_.m.p.ptr().schedtick++
    }
    // 与线程 M 建立起双向的关系
    _g_.m.curg = gp
    gp.m = _g_.m
    // gogo完成从g0到gp的切换
    gogo(&gp.sched)
}
gogo 在不同处理器架构上的实现都不相同,但是不同的实现其实也大同小异,下面是该函数在 386 架构上的实现:
TEXT runtime·gogo(SB), NOSPLIT, $8-4
    MOVL	buf+0(FP), BX		// gobuf
    MOVL	gobuf_g(BX), DX
    MOVL	0(DX), CX		// make sure g != nil
    get_tls(CX)
    MOVL	DX, g(CX)
    MOVL	gobuf_sp(BX), SP	// restore SP
    MOVL	gobuf_ret(BX), AX
    MOVL	gobuf_ctxt(BX), DX
    MOVL	$0, gobuf_sp(BX)	// clear to help garbage collector
    MOVL	$0, gobuf_ret(BX)
    MOVL	$0, gobuf_ctxt(BX)
    MOVL	gobuf_pc(BX), BX
    JMP	BX
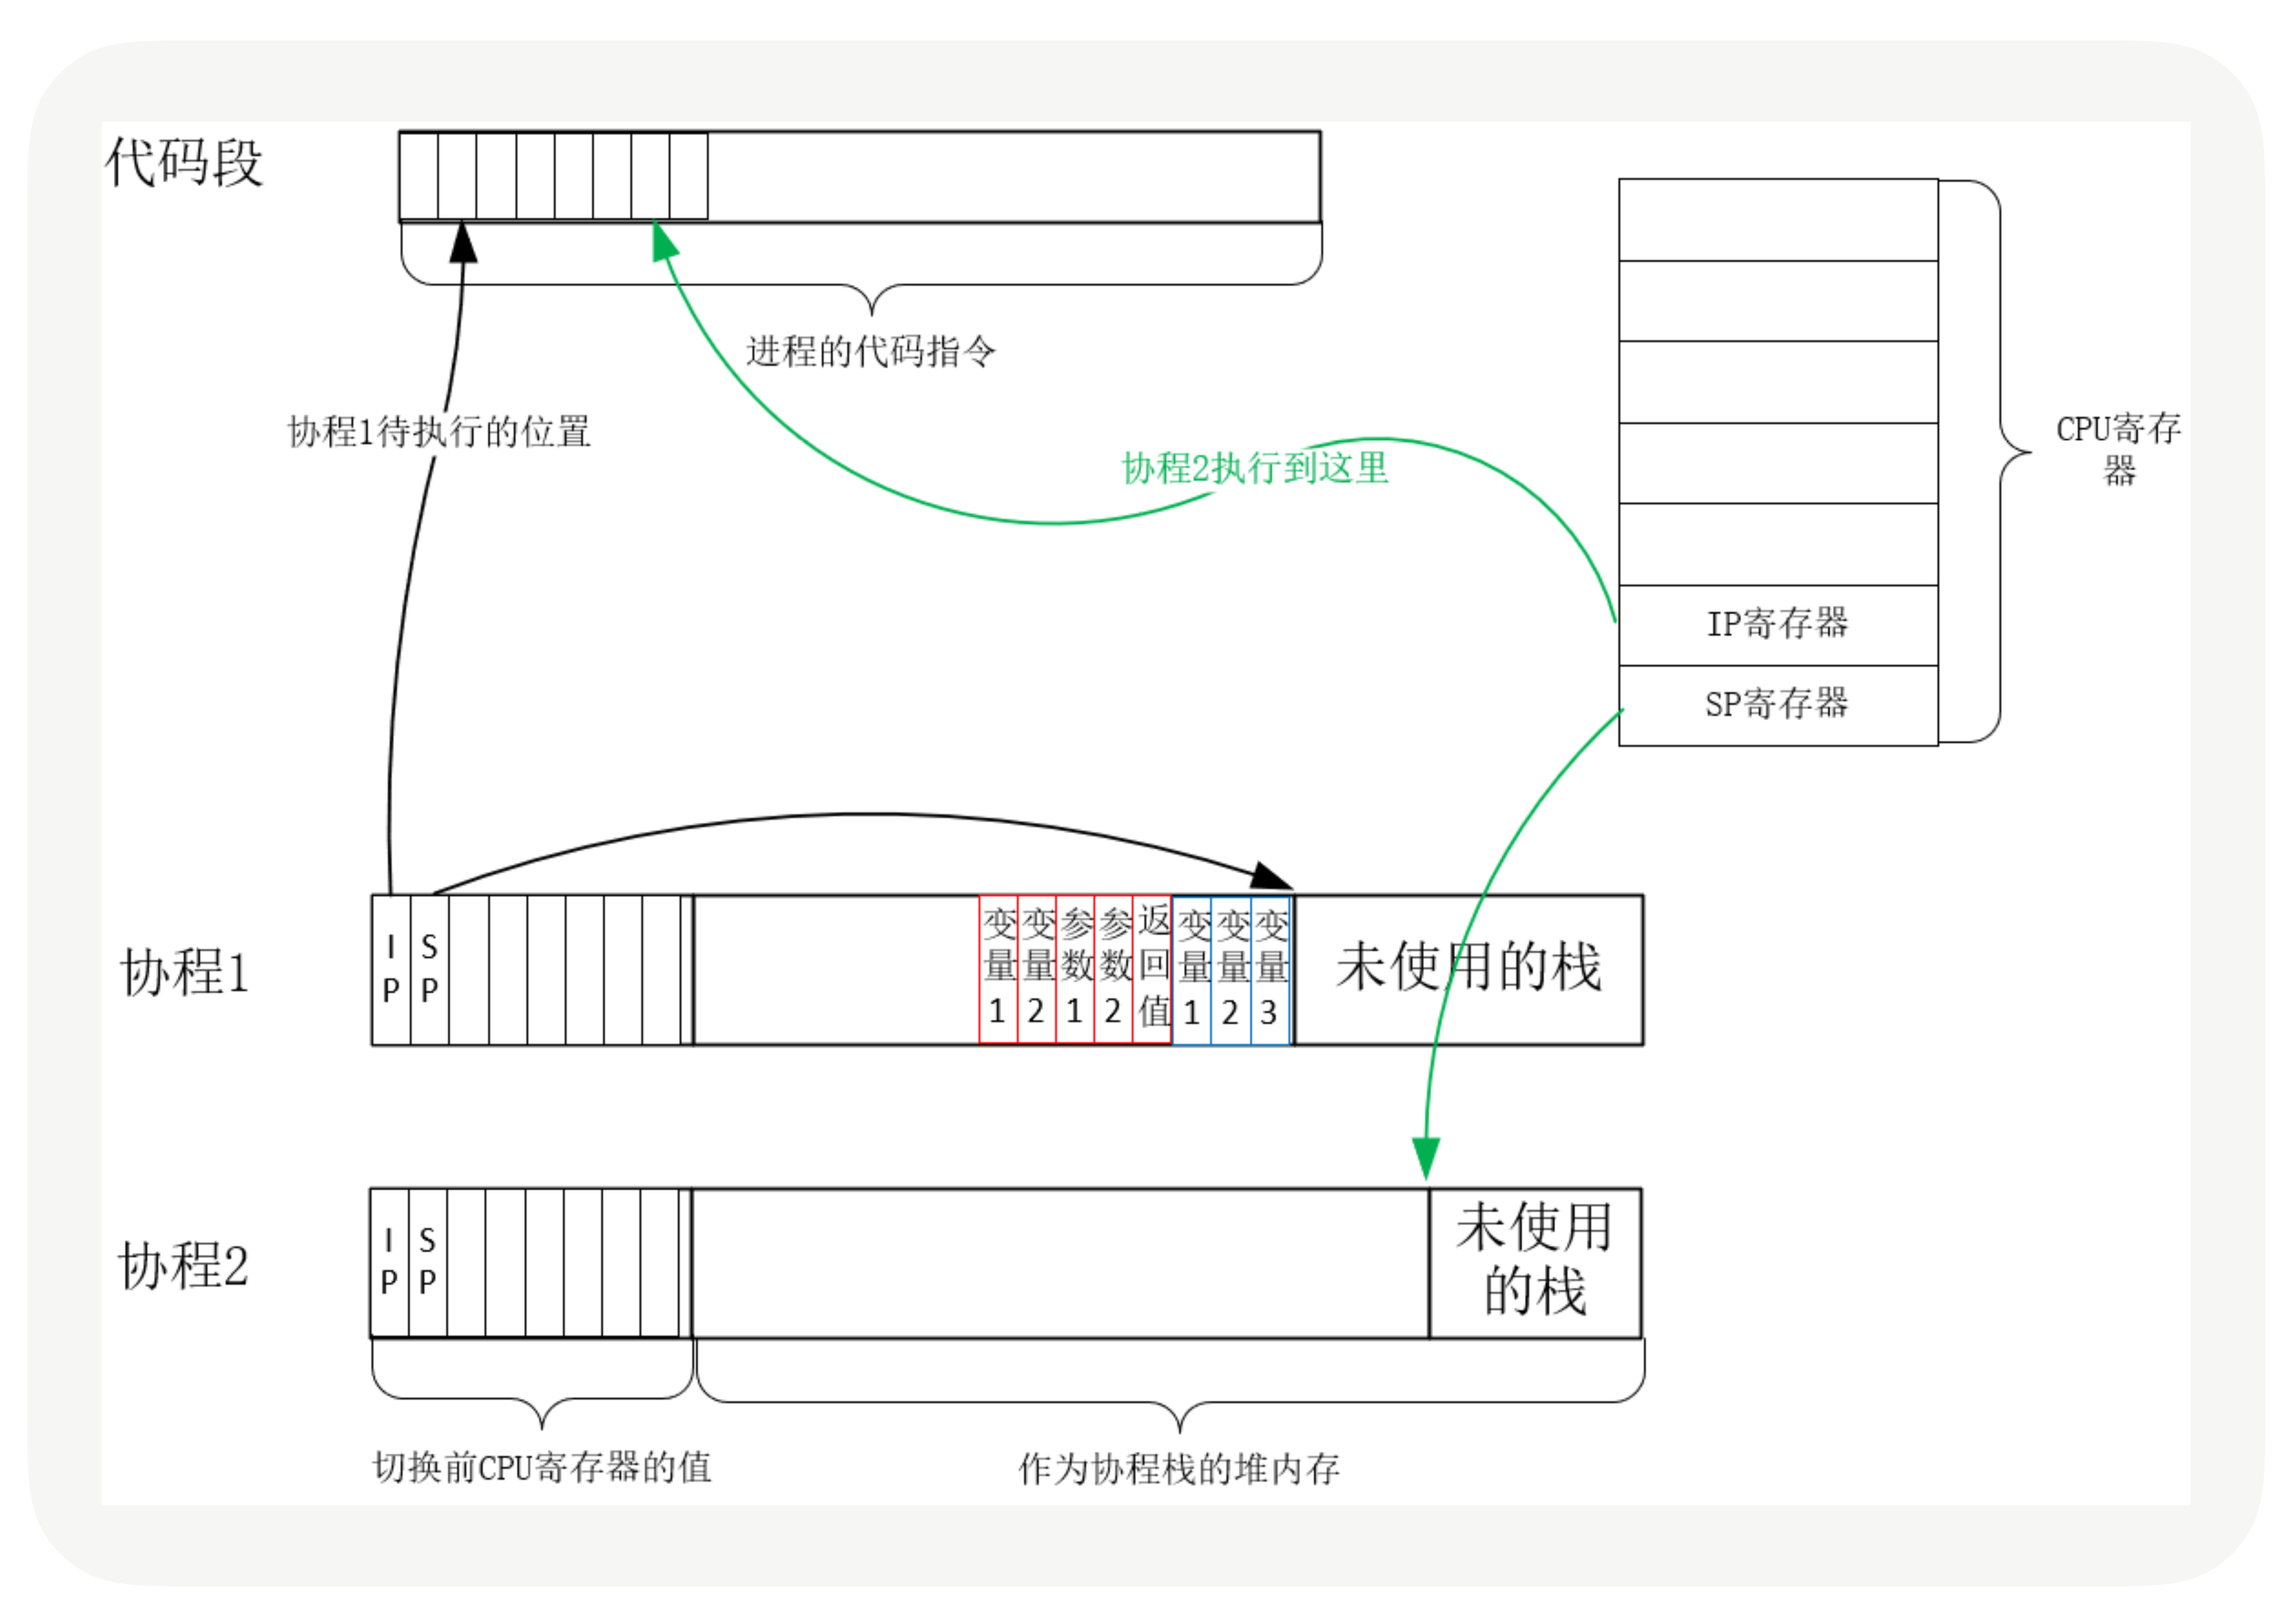
runtime.gogo 中会从 runtime.gobuf 中取出 runtime.goexit 的程序计数器和待执行函数的程序计数器,伪造成goexit函数调用了fn,从而使fn执行完成后执行ret指令时返回到goexit继续执行完成最后的清理工作(所以goroutine 没有返回值)。runtime.goexit ==> runtime·goexit1 ==> mcall(goexit0) ==> goexit0,goexit0 会对 G 进行复位操作,解绑 M 和 G 的关联关系,将其 放入 gfree 链表中等待其他的 go 语句创建新的 g。在最后,goexit0 会重新调用 schedule触发新一轮的调度。PS:就切换几个寄存器,所以协程的切换成本更低
func goexit0(gp *g) {
    _g_ := getg()
    // 设置当前G状态为_Gdead
    casgstatus(gp, _Grunning, _Gdead)
    // 清理G
    gp.m = nil
    ...
    gp.writebuf = nil
    gp.waitreason = 0
    gp.param = nil
    gp.labels = nil
    gp.timer = nil

    // 解绑M和G
    dropg()
    ...
    // 将G扔进gfree链表中等待复用
    gfput(_g_.m.p.ptr(), gp)
    // 再次进行调度
    schedule()
}
图解
初始化
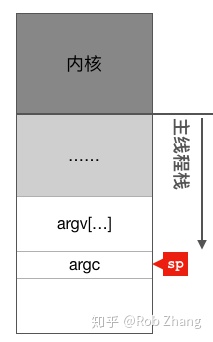
在主线程第一次被调度起来执行第一条指令之前,主线程的函数栈如下图所示:
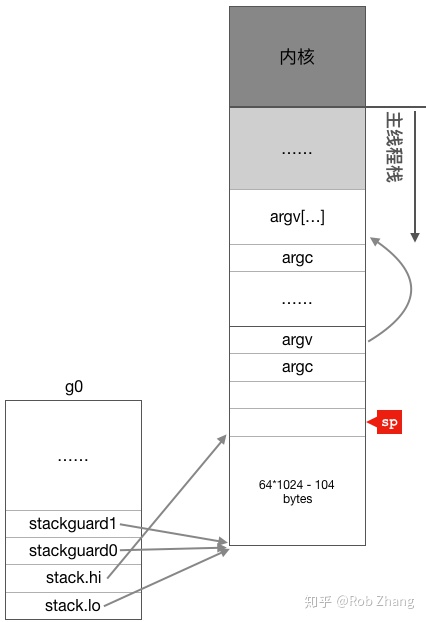
初始化全局变量g0,g0的主要作用是提供一个栈供runtime代码执行。 PS:代码执行就得有一个栈结构存在?
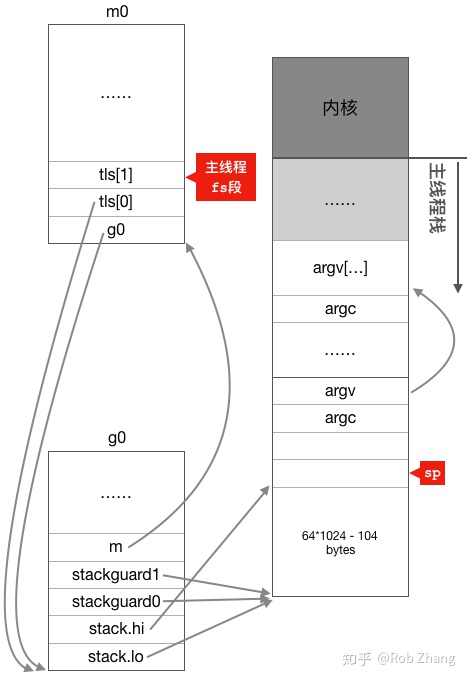
把m0和g0绑定在一起,这样,之后在主线程中通过get_tls可以获取到g0,通过g0的m成员又可以找到m0,于是这里就实现了m0和g0与主线程之间的关联。
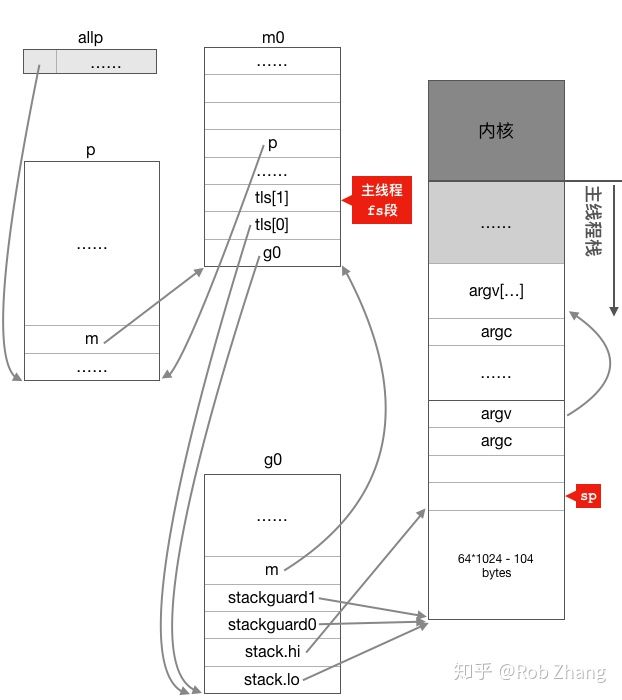
初始化p和allp
创建 main goroutine。多了一个我们称之为newg的g结构体对象,该对象也已经获得了从堆上分配而来的2k大小的栈空间,newg的stack.hi和stack.lo分别指向了其栈空间的起止位置。
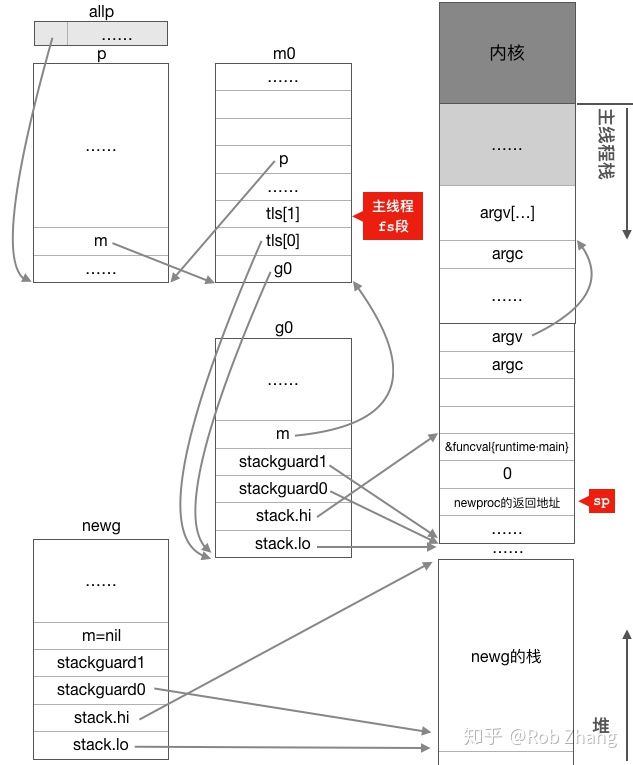
调整newg的栈空间,把goexit函数的第二条指令的地址入栈,伪造成goexit函数调用了fn,从而使fn执行完成后执行ret指令时返回到goexit继续执行完成最后的清理工作;重新设置newg.buf.pc 为需要执行的函数的地址,即fn,我们这个场景为runtime.main函数的地址。修改newg的状态为_Grunnable并把其放入了运行队列
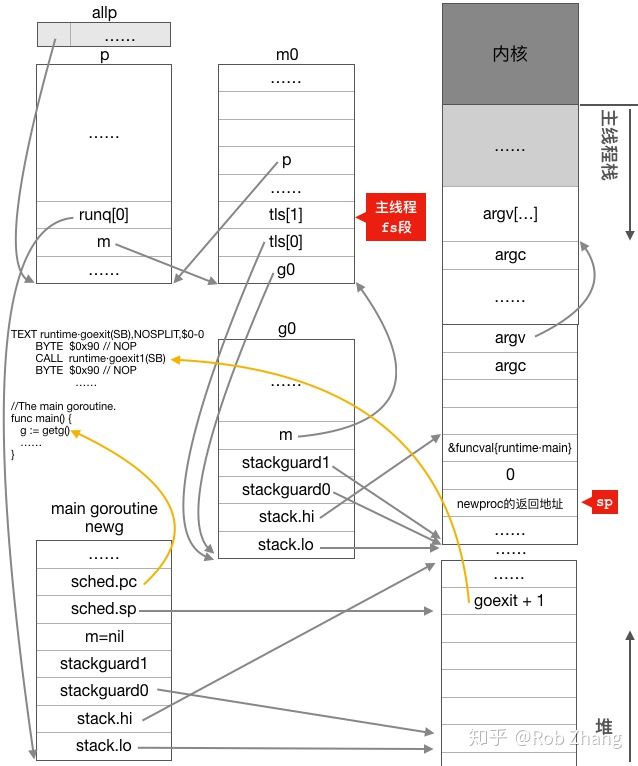
gogo函数也是通过汇编语言编写的,这里之所以需要使用汇编,是因为goroutine的调度涉及不同执行流之间的切换,前面我们在讨论操作系统切换线程时已经看到过,执行流的切换从本质上来说就是CPU寄存器以及函数调用栈的切换(PS:栈的切换没有在之前的意识里),然而不管是go还是c这种高级语言都无法精确控制CPU寄存器的修改,因而高级语言在这里也就无能为力了,只能依靠汇编指令来达成目的。
- 保存g0的调度信息,主要是保存CPU栈顶寄存器SP到g0.sched.sp成员之中;
- 调用schedule函数寻找需要运行的goroutine,我们这个场景找到的是main goroutine;
- 调用gogo函数首先从g0栈切换到main goroutine的栈,然后从main goroutine的g结构体对象之中取出sched.pc的值并使用JMP指令跳转到该地址去执行;
- main goroutine执行完毕直接调用exit系统调用退出进程。
入口函数是runtime.main,runtime.main函数主要工作流程如下:
- 启动一个sysmon系统监控线程,该线程负责整个程序的gc、抢占调度以及netpoll等功能的监控
- 执行runtime包的初始化;
- 执行main包以及main包import的所有包的初始化;
- 执行main.main函数;
- 从main.main函数返回后调用exit系统调用退出进程;
非main goroutine执行完成后就会返回到goexit继续执行,而main goroutine执行完成后整个进程就结束了,这是main goroutine与其它goroutine的一个区别。
func g2(n int, ch chan int) {
    ch <- n*n
}
func main() {
    ch := make(chan int)
    go g2(100, ch)
    fmt.Println(<-ch)
}
“M的”调度循环
M 是 Go 代码运行的真实载体,包括 Goroutine 调度器自身的逻辑也是在 M 中运行的。M在绑定有效的 P 后,进入一个调度循环,而调度循环的机制大致是从 P 的本地运行队列以及全局队列中获取 G,切换到 G 的执行栈上并执行 G 的函数,调用 goexit 做清理工作并回到 M,如此反复。
伪代码
for i:=0;i<N;i++{   // 创建N个操作系统线程执行schedule函数
    create_os_thread(schedule)
}
func schedule(){
    for{
        g := find_a_runnable_goroutine_from_M_goroutines();
        run_g(g)    // cpu 运行该goroutine,直到需要调度其它goroutine 才返回
        save_status_of_g(g) // 保存goroutine的状态,主要是寄存器的值
    }
}
m 拿到 goroutine 并运行它的过程就是一个消费者消费队列的过程
schedule()->execute()->gogo()->用户协程->goexit()->goexit1()->mcall()->goexit0()->schedule()
一轮调度是从调用schedule函数开始的,然后经过一系列代码的执行到最后又再次通过调用schedule函数来进行新一轮的调度,从一轮调度到新一轮调度的这一过程我们称之为一个调度循环,这里说的调度循环是指某一个工作线程的调度循环,而同一个Go程序中可能存在多个工作线程,每个工作线程都有自己的调度循环,也就是说每个工作线程都在进行着自己的调度循环。
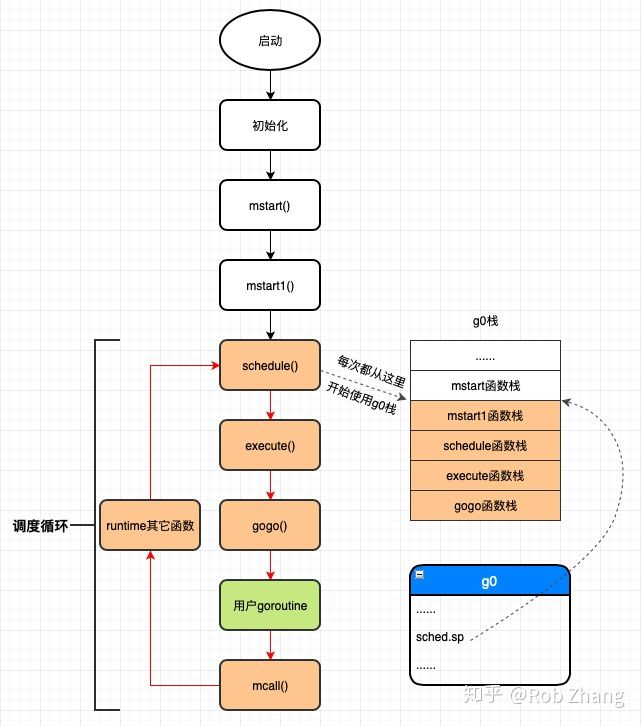
调度策略——抢占——防止一个G长时间运行
Go 的抢占式调度有两种主要的多任务调度方法:“协作”和“抢占”。协作式多任务处理也称为“非抢占”。在协作式多任务处理中,程序的切换方式取决于程序本身。“协作”一词是指这样一个事实:程序应设计为可互操作的,并且它们必须彼此“协作”。在抢占式多任务处理中,程序的切换交给操作系统。调度是基于某种算法的,例如基于优先级,FCSV,轮询等。
那么现在,goroutine 的调度是协作式还是抢占式的?至少在 Go1.13 之前,它是协作式的。当 sysmon 发现 M 已运行同一个 G(Goroutine)10ms 以上时,它会将该 G 的内部参数 preempt 设置为 true。然后,在函数序言中(Go 编译器在每个函数或方法的入口处加上了一段额外的代码 runtime.morestack_noctxt),当 G 进行函数调用时,G 会检查自己的 preempt 标志,如果它为 true,则它将自己与 M 分离并推入“全局队列”。
func main() {
    go fmt.Println("hi")
    // 在go1.13及之前,如果没有函数调用,即使设置了抢占标志,也不会进行该标志的检查。
    for {
    }
}
Go1.14 引入抢占式调度(使用信号的异步抢占机制),sysmon 会检测到运行了 10ms 以上的 G(goroutine)。然后,sysmon 向运行 G 的 P 发送信号(SIGURG)。Go 的信号处理程序会调用P上的一个叫作 gsignal 的 goroutine 来处理该信号,将其映射到 M 而不是 G,并使其检查该信号。gsignal 看到抢占信号,停止正在运行的 G。PS: os 中断是指令完毕时,进而执行中断处理程序,重新拿到cpu使用权
Go的栈
- 多任务操作系统中的每个进程都在自己的内存沙盒中运行。PS: 内存的沙盒
- 栈是一种栈数据结构,用于存储有关计算机程序的活动 subroutines 信息。栈帧stack frame又常被称为帧frame是在调用栈中储存的函数之间的调用关系,每一帧对应了函数调用以及它的参数数据。
- linux线程的栈是os 进程内存模型的一部分,task_struct 是描述进程/线程的一个环节,栈跟task_struct 关系不大。而goroutine的栈是runtime/编译器分配的, 就在goroutine struct中(待确认)。在 Goroutine 中有一个 stack 数据结构,里面有两个属性 lo 与 hi,描述了实际的栈内存地址。创建goroutine 时将栈赋给goroutine: runtime·newproc ==> runtime.newproc1 ==> malg(stacksize)
- 栈会根据大小的不同从不同的位置进行分配。
- 小栈内存分配。从 stackpool 分配栈空间,否则从 mcache 中获取。如果 mcache 对应的 stackcache 获取不到,那么调用 stackcacherefill 从堆上申请一片内存空间填充到 stackcache 中。
- 大栈内存分配。运行时会查看 stackLarge 中是否有剩余的空间,如果不存在剩余空间,它也会调用 mheap_.allocManual 从堆上申请新的内存。