BFF
目录
简介
GraphQL is a query language for APIs and a runtime for fulfilling those queries with your existing data. 为什么我使用 GraphQL 而放弃 REST API?
用搭积木的方式写业务 GraphQL及元数据驱动架构在后端BFF中的实践
聊聊我对 GraphQL 的一些认知 GraphQL 留给我的印象就停留在这些无法解决的问题上。曾经有人咨询我想用 GraphQL 去重构某个服务,被我比较激动的给打消了这个念头。
基于 GraphQL 平台化 BFF 构建及微服务治理 从理念到实现到落地比较成体系。
需求
- 不知道大家有没有遇到过这样的一些场景,某个服务有几十个接口,更有甚者上百个也是有可能的。APP 或者其他下游要封装一个功能,需要调用 10 个接口左右,可能这些接口还涉及到不同的团队。不管开发,联调,测试,还是对于调用方,整个链条功能太多了。随着这些功能经过多个版本的迭代升级后,新+旧版本的接口谁也不敢大规模改动了,只能在原来的基础上做代码拼接,这基本就是祖传代码的由来。大部分同学基本的代码素养是有的,但是也只能任由这些祖传代码慢慢腐烂,原因为很简单,谁也不敢保证改动之后功能是不是有遗漏的地方。有没有这样一个功能,将这些接口做一下聚合,然后将结果的集合返回给前端呢?在目前比较流行微服务架构体系下,有一个专门的中间层专门来处理这个事情,这个中间层叫 BFF(Backend For Frontend)。
- 当用户打开这个页面的时候,按照目前比较流行的 REST 接口,需要 APP 至少发起下面这些请求:获取商品详情接口;获取商品价格、优惠相关的接口;获取评价接口;获取种草秀接口;获取问答接口。这些接口一般来说都比较重,里面有很多当前页面并不需要的字段,那有没有一种可能:APP 端发一次请求就能获取这个页面需要的所有字段,同时 APP 还能根据自己的需求只请求自己需要的字段呢?
基于 GraphQL 平台化 BFF 构建及微服务治理从本质上来说是前端面向页面场景和后端面向业务领域之间的矛盾,由 BFF 这层来解决。但BFF 也只是为了解耦前端和后端间的依赖而增加的一层,BFF 内部还是存在的非常多的问题。
- 按需取数,比如在 App 端上,完整的获取数据可能需要 100 个字段,对应 10 个接口。而在 Mobile Web 上,这个页面可能只需要 50 个字段,对应 6 个接口。
- 页面差异化兼容,比如 Web 端需要完全平铺的字段结构,而 App 上可以接受结构化对象结构。
- 不同版本的差异化兼容,在原生的 APP 上,BFF 层需要针对不同的版本做不同的处理。因此我们引入了路由的能力来解决这个问题。不同的版本或者 iOS/Android 端映射到不同的 API 接口上,API 内处理 GraphQL 的调用和 JSON 模板映射
效果
query jdGoodsQuery {
     goods {
        detail {
          id
          pictures(first: 10) {
            pic_id
            thumb
          }
          spec {
            name
            size
            weight
          }
        }
        price {
          price
          origin_price
          market_price
        }
        comment(first: 10) {
          comment_id
          topic_id
          content
          from_uid
        }
        self_show(first: 10) {
          id
          pic_id
        }
    }
}
对于上面京东商品详情的截图,类似这样的一个 Query 就可以把这个页面需要的所有的字段都获取到。
整体实现
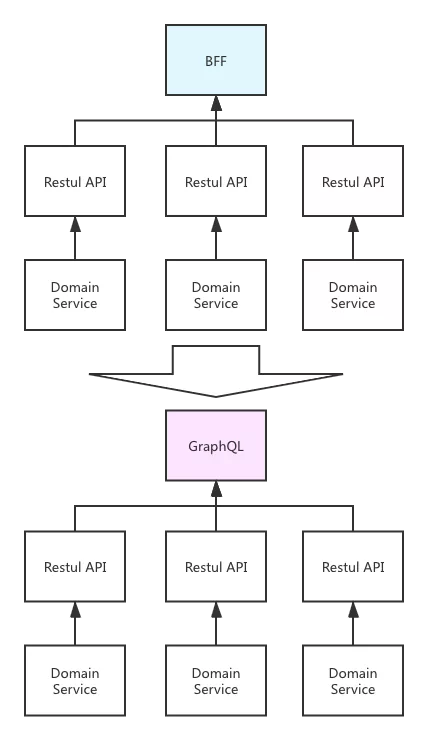
- 数据获取:多领域的按需取数和数据聚合 —— 引入 GraphQL
- 数据转换:一种 JSON 结构转换成另外一种 —— 引入 JSON 模板
- 请求映射:多版本兼容 —— 引入路由能力
GraphQL:从 GraphQL query 到json 响应
首先定义了一套类型系统/schema,这里 type 可以对应到 Java 语言中的 class
type Query {
  me: User
}

type User {
  id: ID
  name: String
}
下面一段 GraphQL 的 query 语句,通过 Query 对象的入口,就可以开始对 GraphQL 对象进行查询了。
{
  me {
    name
  }
}
很像db 支持sql 定义table(schema),然后用select 查询table 数据。
在 GraphQL 的实现里,是通过实现 DataFetcher 的接口来获取真正的数据的,例如调用 RESTful 接口或者调用 RPC 接口,都是封装在这里。DataFetcher 可以绑定在某个 type 的某个字段上,这样当访问到这个字段时, GraphQL 会自动调用这个 DataFetcher 来获取数据,没有使用到这个字段自然也不会请求。也是因为绑定到字段的原因,我们实现 DataFetcher 的时候可以聚焦在单一数据类型的获取上,而把多类型的数据关联交给 GraphQL 自己来完成。通过 GraphQL 这样的能力,我们即可以按需选择需要的数据字段,也可以让 GraphQL 自动帮助我们组装多个数据对象的数据。
在工程上
- 假设有一个rpc/rest api 接口,可以对应编写一个schema,针对这个schema 实现DataFetcher,在DataFetcher内可以使用restClient 访问rest api,之后,就可以以 GraphQL query 的方式来访问这个api 接口了
- 根据rpc/rest api 可以将上述 生成schema 和 DataFetcher 的逻辑自动化, 比如提交一个rpc api jar包,扫描rpc api jar 自动生成schema 注册到 GraphQL 网关中,生成 rpc DataFetcher jar 加载到GraphQL 网关中。
json 模板: 从json到 页面需要的json
前端页面所需的 JSON 字段的结构和 GraphQL 查询结果的 JSON 结构往往不相同,而且页面上也存在一些 format、if-else 的判断逻辑,这部分放在 GraphQL 里的话其实很难实现。我们采用 JSON 模板来对这两个不同的 JSON 结构进行映射。
//GraphQL 的结果,模板的输入 JSON
{
  "data": [
    {
      "id": 10000,
      "title": "房子 1",
      "roomNum": 2,
      "hallNum": 2,
      "area": 90.12
    }, {
      "id": 10001,
      "title": "房子 2",
      "roomNum": 3,
      "hallNum": 2,
      "area": 99.34
    },
    ...
  ]
}
//JSLT 模板
{
  "dataList": [
    for( .data) {
      "id": .id,
      "title": .title,
      "label1": "户型",
      "text1":  .roomNum + "室" + .hallNum + "厅" ,
      "label2": "面积",
      "text2": .area +"㎡",
      "link": URLRoute("HousePage", {"id": .id})
    }
  ]
}
//输出JSON
{
  "dataList": [
    {
      "id": 10000,
      "title": "房子 1",
      "label1": "户型",
      "text1":  "2室2厅",
      "label2": "面积",
      "text2": "90.12㎡",
      "link": "https://anjuke.com/house.html?id=10000"
    },
    {
      "id": 10001,
      "title": "房子 2",
      "label1": "户型",
      "text1":  "3室2厅",
      "label2": "面积",
      "text2": "100.34㎡",
      "link": "https://anjuke.com/house.html?id=10001"
    }
  ]
引入路由能力
路由这部分比较简单,主要就是根据不同的端、版本、iOS/Anroid 等参数,映射到对应的 GraphQL 请求和 JSON 模板上即可。
构建 BFF 平台
BFF 的开发工作其实比较模板化
- 数据获取:编写 GraphQL query,调用 GraphQL 服务获取数据
- 数据转换:编写 JSON 模板,转换成前端需要的 JSON 结构
- 请求映射:编写路由逻辑,映射到对应的 GraphQL 请求和 JSON 模板上
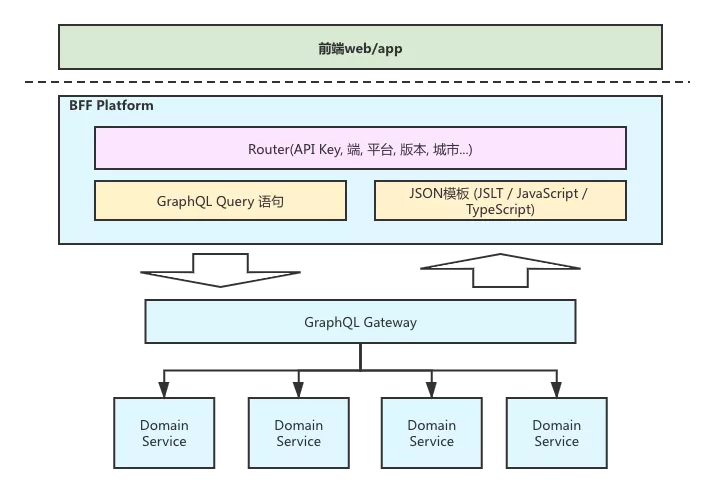
- 统一请求入口:BFF 平台负责对外部统一的 API 接口
- 请求映射:根据请求参数和内部配置的路由规则,把请求映射到不同的配置模板上
- 获取模板信息:单个配置模板里, 保存着 GraphQL 的 query 语句和 JSON 映射模板
- 数据获取:使用 GraphQL query 语句调用 GraphQL 网关,获取数据结果
- 数据转换:调用模板引擎,进行 JSON 结构的转换,并将数据返回给调用方 通过上述几个步骤,我们的 BFF 平台可以支持非常快速的实现一个 API 来对外提供服务。BFF 平台由后端负责开发和维护,保证服务的性能和稳定性。前端主要的工作使用 BFF 平台写 query 和模板,完成页面的数据拼装。通过这样的方式,前端和后端都能够最大化的发挥自己的擅长的能力,优化团队研发效率。